登录社区云,与社区用户共同成长
邀请您加入社区
参考github网址:https://github.com/OpenDriveLab/UniAD/tree/v2.0参考readme:https://gitcode.com/Ascend/DrivingSDK/blob/master/model_examples/UniAD/README.md。
NVIDIA GeForce RTX 5070Ti 的架构可能为 Ada Lovelace(假设为 sm_89),而 PyTorch 默认安装的预编译版本通常支持 sm_50 到 sm_86。确保 CUDA 12.1+ 和 cuDNN 已安装,并验证驱动版本 ≥535.86(支持 RTX 5000 系列)。不兼容,可能是 PyTorch 版本与 GPU 架构不匹配。
尽管C++不像Python那样拥有一个如PyTorch或TensorFlow的庞大生态,但仍有一些功能强大且高效的工具包,可以在C++中进行机器学习和深度学习任务。对于那些需要极高性能和嵌入式应用的场景,C++框架(如LibTorchCaffe等)依然是非常有竞争力的选择。如果只是进行较简单的机器学习任务,像Dlib和Shark也是不错的选择。
Genesis是一款由卡内基梅隆大学、马里兰大学、斯坦福大学、麻省理工学院等全球顶尖研究机构联合开发的开源生成式物理引擎。于2024年12月19日正式开源。它专为机器人、嵌入式 AI 和物理 AI 应用设计,能够模拟各种物理现象(如刚体、液体、软体等),并通过自然语言描述生成交互式 3D 场景、机器人策略和面部动画。
用户类型推荐框架原因AI 初学者PyTorch简单清晰,像写 NumPy,调试直观科研人员PyTorch动态图好调试,社区论文支持强工程部署TensorFlowTensorFlow Serving + Lite 更强跨平台开发者TensorFlow支持 Web、移动、嵌入式部署模型优化研究者二者皆可PyTorch(),TF(XLA)选 PyTorch;选 TensorFlow。
在半导体晶圆缺陷检测系统中,YOLOv11模型能够识别六大类晶圆缺陷,包括短路(short_circuit)、划痕(scratch)、开口(open)、嵌入式污渍(stains_enbedded)、灰线(gray_line)和边缘咬痕(edge_bite)。YOLOv11在之前的YOLO版本基础上进行了诸多改进和创新,引入了新的功能和架构优化,如C3K2块、SPFF模块和C2PSA块等,这些改进显
模型量化(Model Quantization)是一种模型压缩和加速技术,通过将模型中的高精度数值(通常是32位浮点数,FP32)转换为低精度表示(如8位整数,INT8,或更低的位数),来减少模型的存储需求、计算量和推理延迟,同时尽量保持模型的精度。量化广泛应用于深度学习模型的部署,特别是在资源受限的设备(如移动端、嵌入式设备)上。本文还包括一个具体的代码示例,展示如何使用PyTorch进行训练后
TensorFlow Lite 端侧部署技术解析 TensorFlow Lite (TFLite) 是 Google 专为移动和嵌入式设备开发的轻量级深度学习框架,支持 Android、iOS、Raspberry Pi 等平台。其核心架构包含模型转换器和解释器,可将 TensorFlow 模型优化为 .tflite 格式,显著提升设备端推理效率。 端侧部署具有五大优势: 低延迟(1-50ms) 数
批处理命令有很多,包括用于在控制台显示文本信息的echo,用于创建或修改环境变量的set,用于在批处理文件中进行条件判断的if,用于循环读取文件或列表中的数据的for,用于跳转到批处理文件中的指定标签的goto,用于调用另一个批处理文件的call,用于创建新的目录的md或mkdir,用于删除文件的del,以及用于复制文件或目录的copy等。系统调用是操作系统提供给应用程序使用的接口,可以理解为一种
对比损失模型的特征向量量化:采用混合精度(FP16存储,FP32计算)负样本队列压缩:使用乘积量化(PQ)将队列存储成本降低70%
今天又来给大家推荐一本人工智能方面的书籍。TensorFlow是一个开源机器学习库。
摘要:本文探讨了在资源受限设备上通过MLFlow加载优化PyTorch模型的方法。主要从三方面展开:1)模型优化技术(量化、剪枝、知识蒸馏)在MLFlow中的集成应用;2)轻量级MLFlow运行时开发方案;3)跨平台兼容性处理(ARM/x86架构差异)。通过量化可降低75%内存占用,剪枝减少50%模型大小,知识蒸馏保留30%计算资源。同时提供了具体实现代码示例和部署建议,包括使用QEMU模拟测试和
本文介绍了如何利用PyTorch和OpenCV实现一个简单的物体追踪系统,适用于视频监控、自动驾驶和机器人导航等领域。文章首先概述了PyTorch和OpenCV的基础知识,PyTorch用于加载和运行预训练的目标检测模型,而OpenCV则用于处理视频流和绘制追踪框。接着,文章详细解释了物体追踪的基本原理,包括基于特征、深度学习和光流法的追踪方法。随后,文章指导读者如何搭建开发环境,并提供了代码实现
计算机视觉,作为人工智能的一个中心领域,正在迅速改变我们与世界的交互方式。近年来,深度学习在图像识别、目标检测和生成等任务上取得了显著进展。而 PyTorch 作为一个灵活且强大的深度学习框架,成为开发计算机视觉应用的热门选择。本文将探讨 PyTorch 在计算机视觉中的应用、具体使用步骤、以及职业发展的机遇。
PyTorch 2.8.1 架构感知初始化。
输入层→隐藏层:28x28=784维输入,512维输出(🔍 注意:此处故意写错为28*24=672,制造维度错误)self.fc1 = nn.Linear(28*24, 512) # 正确应为28*28=784,此处将导致后续维度不匹配错误self.relu = nn.ReLU() # 激活函数,引入非线性映射self.dropout = nn.Dropout(0.5) # 防止过拟合,训练时随
然而,测试工程师仍然需要设计、维护和管理这些自动化测试脚本,并解释测试结果。总体而言,AI在软件测试中的应用可以提高效率和覆盖范围,但测试工程师仍然需要在测试过程的各个阶段发挥关键作用,确保测试的全面性、准确性和高质量。测试工程师需要制定全面的测试策略,确保整个系统的质量。AI可以在某些方面提供支持,但测试工程师的专业知识仍然是不可或缺的。这需要测试工程师具备创造性思维,能够模拟用户的实际使用场景
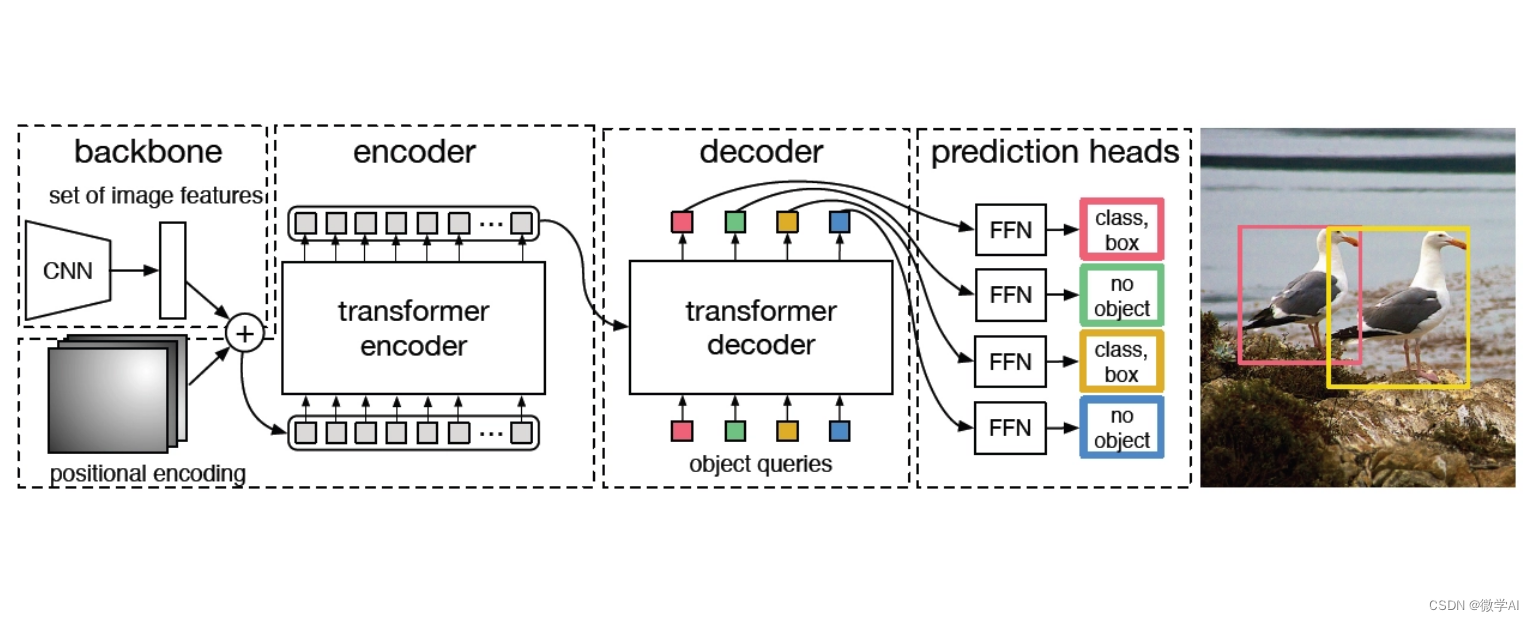
DETR是一款基于Transformer的端到端目标检测模型,由Facebook AI研发,革新了传统检测方法。它摒弃了区域提议和锚点生成,直接从图像中预测位置和类别,通过全局特征捕获和解码器的自注意力机制进行目标生成与定位。其核心是将检测视为集束搜索问题,简化了流程并提升效率。虽然计算成本较高,适用于大规模数据和高分辨率场景有限,但DETR展示了深度学习在目标检测领域的创新潜力,预示着未来技术的
随着2025应用人工智能和深度学习技术的举世泛气,还在迷茫于该选择哪个深度学习框架吗?PyTorch和TensorFlow是并立于深度学习世界两座巨塔,但是越来越多人发现,在2025年,PyTorch似乎比TensorFlow更为流行和被接受。下面我来分析一下这两个深度学习框架的发展历史,应用差异和现状,以及这些应用应该如何影响你的选择。
bge-base-zh-v1.5可以直接从魔搭下载。1.对文本进行相似度比较。
内存优化:仅保存变化的参数(伪代码)# 首次全量保存else:# 计算参数变化量# 增量保存state = {
CNN 的stridestride:是filter 滑动图像的步长例如:stride = 1 ,对于一个7 * 7 的灰白图片,通过一个3 * 3 大小的filter,输出下一个图片的大小为5 * 5 (如何计算呢?公式呢?)(W-F+2P/S) + 1 = (7 - 3 + 0)/1 + 1 = 5stride = 2 ,对于一个7 * 7 的灰白图片,通过一个3 * 3 大小的f...
值得注意的是,在实践中,剪枝后的模型可能需要进行微调,以进一步提高其性能。在训练模型之后,我们使用全局非结构化剪枝方法对模型的卷积层和两个全连接层的权重进行剪枝,剪枝后的比例为20%。使用该模型进行交通信号灯的识别时,我们只需要将输入的图像数据传入该模型的forward函数即可得到模型的输出,然后使用argmax函数取最大值所在的索引作为该图像的类别。模型(Model):在PyTorch中,可以使
以下整理了 30 个 Kaggle 经典比赛,覆盖计算机视觉、自然语言处理、表格数据等不同类型。每个比赛都注明了核心任务、赛题简介、适合的学习阶段和数据集来源,供学习者使用 PyTorch 进行复现和练习。
环境隔离:通过Anaconda虚拟环境避免依赖冲突,这是工业级开发的必备习惯安装策略:常规开发选Conda(稳定),追求新功能选Pip(灵活),复杂场景编译源码(定制)问题排查:善用conda listpip list查看版本,优先通过官方渠道解决依赖。
222
本demo使用 text2vec-large-chinese 模型进行文本处理,然后再过 bge-reranker-v2-m3进行增强。3. 使用rerank增强 ,rerank模型:bge-reranker-v2-m3。1. 对文本进行向量处理,并保存只至本地。2. 普通相似度匹配。
PyTorch Geometric 2.3.0 动态残差GCN层# 传统GCN传播# 残差连接# 动态权重融合。
学习过线性代数的话,你可能对矩阵比较熟悉,张量其实就是矩阵向任意维度的推广。(1)如果一个矩阵只有一个元素,那么它被称为0阶张量;(2)如果一个矩阵只有一行或者一列(我们称其为只有一个“轴”),则被称为一阶张量;(3)显然,大部分的矩阵都有m行n列(有两个轴),则就被称为二阶张量;(4)如果将一个二阶张量看作一个整体,由多个二阶张量组成一个新的数组,则二阶张量就被推广为三阶张量;当然,我本人有个小
我们知道 CPU 做计算靠的是 RAM,GPU 做计算靠的是 VRAM(Video Random Access Memory),VRAM 是 GPU 的专用内存。苹果的 MPS(Metal Performance Shaders)扩展了 PyTorch 框架,可以作为 PyTorch 的后端加速 GPU 训练,它提供了在 Mac 上设置和运行操作的脚本和功能,MPS 通过针对每个 Metal GP
注意力热力图可视化(适用于Transformer模型)梯度流追踪(显示各层梯度传播强度)自定义指标仪表盘。
本篇即针对医学影像中的胸部X射线部分进行研究,利用公开数据集+开源算法YOLOv8来训练模型,模拟医疗胸X射线方向实用场景。
更隐蔽的是,某医疗影像团队使用固定学习率训练3D-UNet时,分割准确率长期停滞在78%,调整学习率策略后直接提升至89%。那些在学习率设置上得心应手的工程师,往往具备三重能力:理解梯度下降的物理意义,掌握场景化调整策略,精通工程化验证工具。(全文5300字,包含15个可运行代码块、8张技术示意图、20个专家提示框,通过数学推导、场景化策略和工程实践,系统解析学习率设置的核心误区与科学方法,符合C