Linux嵌入式基础知识
一个嵌入式Linux系统从软件的角度通常分为哪几个层次
一个嵌入式Linux系统从软件的角度看通常可以分为四个层次:
1、 引导加载程序:包括固化在固件(firmware)中的boot代码(可选),和BootLoader两大部分。
2、Linux内核:特定于嵌入式板子的定制内核以及内核的启动参数。
3、 文件系统:包括根文件系统和建立于Flash内存设备之上文件系统。通常用ramdisk来作为rootfs。
4、 用户应用程序:特定于用户的应用程序。有时在用户应用程序和内核层之间可能还会包括一个嵌入式图形用户界面。常用的嵌入式GUI有:MicroWindows和MiniGUI等。
Flash存储器中包含哪些分区
在Linux驱动开发中,Flash内存通常被划分为多个部分,每个部分都有特定的用途。除了Bootloader之外,通常还包括以下部分:
-
Bootloader:这是启动时运行的第一个程序,负责初始化硬件,并加载操作系统内核。
-
Kernel Image:即Linux内核的镜像文件,由Bootloader加载到RAM中并执行。
-
Device Tree Blob (DTB):设备树文件,描述硬件配置信息,用于在引导时向内核传递硬件信息。
-
Root File System:根文件系统,包含操作系统运行所需的文件、库、应用程序等。它可以是以下几种类型:
-
Initramfs:一个临时的根文件系统,通常嵌入在内核镜像中,用于引导过程。
-
SquashFS:一种压缩的只读文件系统,常用于嵌入式系统。
-
JFFS2/UBIFS:适用于Flash存储的可读写的文件系统。
-
-
Boot Configuration:如U-Boot的环境变量等,用于配置启动参数。
-
Firmware:一些硬件设备可能需要固件,这些固件有时也会存储在Flash中。
-
User Data:应用程序数据或用户数据分区。
在嵌入式Linux系统中,Flash的分区布局通常由Bootloader和内核共同定义。常见的分区表可能包括:
-
bootloader分区
-
kernel分区
-
dtb分区
-
rootfs分区
-
其他自定义分区
在驱动开发中,我们需要了解这些分区的位置和内容,以便正确地进行读写操作。例如,MTD(Memory Technology Device)子系统就是Linux中用于管理Flash存储的框架,它可以将Flash划分为多个分区,每个分区可以作为一个独立的MTD设备出现。
因此,在编写Flash驱动时,我们需要考虑如何支持这些分区,并确保每个分区都能被正确访问和操作。
uboot
uboot是用来干什么的,有什么作用?
uboot属于bootloader的一种,是用来引导启动内核的,它的最终目的就是,从flash中读出内核,放到内存中,启动内核。所以,UBOOT需要具有读写flash的能力。
uboot是怎样引导启动内核的?
uboot刚开始被放到flash中,板子上电后,会自动把其中的一部分代码拷到内存中执行,这部分代码负责把剩余的uboot代码拷到内存中,然后uboot代码再把kernel部分代码也拷到内存中,并且启动,内核启动后,挂着根文件系统,执行应用程序。
手机的 Bootloader 启动过程与计算机系统有些许不同。下面是一个典型的手机 Bootloader 启动过程:
- 加载 Bootloader:当手机上电后,Bootloader 被加载到内存中执行。一般来说,手机的 Bootloader 存放在闪存中,而不是在硬盘上。
- 初始化环境:在 Bootloader 开始执行后,它会初始化基本的硬件环境,例如 CPU、内存、屏幕、摄像头等。
- 加载引导程序:此时,Bootloader 会从闪存中读取引导程序,把它加载到内存中运行。引导程序会负责进一步的初始化动作,如设置与操作系统相关的参数和数据结构。
- 加载内核镜像:在引导程序运行之后,Bootloader 开始加载操作系统内核镜像。内核镜像是一个包含了操作系统核心代码的文件,通常位于闪存中或者通过网络下载。
- 启动内核:最后,Bootloader 把操作系统内核映像的控制权交给内核,启动操作系统。内核会进一步初始化系统,完成各种驱动程序的加载,然后启动 Shell 或图形用户界面。
总之,手机 Bootloader 启动分为加载 Bootloader、初始化硬件环境、加载引导程序、加载内核镜像和启动内核这五个主要阶段。每个阶段都有着自己的任务和目的,都是启动过程中必不可少的一部分。
大多数Bootloader都包含两种不同的操作模式:
(1)启动加载模式
在这种模式下,Bootloader从目标机的某个固态存储设备上将操作系统加载到RAM中运行,整个过程并没有用户的介入。这种模式是Bootloader的正常工作模式,因此在嵌入式产品发布时,Bootloader必须工作在这种模式下。
(2)下载模式
在这种模式下,目标机上的Bootloader将通过串口或网络等通信手段从开发主机(Host)上下载内核映像和根文件系统映像等到RAM中,然后可再被Bootloader写到目标机上的固态存储媒质中,或者直接进行系统的引导。
启动加载模式通常用于第一次烧写内核与根文件系统到固态存储媒质时或者以后的系统更新时使用;下载模式多用于开发人员在前期开发的过程中,工作于这种模式下的Bootloader通常都会向它的终端用户提供一个简单的命令行接口。
linux内核
head.S 是操作系统内核的第一个汇编文件,主要用于设置 CPU 状态、堆栈、跳转到 C 代码中的启动函数等,以便能够顺利地将控制权转移给操作系统内核。
主要功能包括:
-
清空 bss 段:清空操作系统内核中的 bss 段,避免未初始化变量的问题。
-
设置基础寄存器:设置操作系统内核的基础寄存器,包括栈、堆等。
-
加载内核代码:加载操作系统内核代码到内存中,并跳转到内核代码的入口处开始执行。
start.S 则是内核启动过程中的第二个汇编文件,它在 head.S 完成初始化后,进一步设置内核的运行环境、MMU、缓存等,并调用 C 代码中的启动函数 start_kernel。
start.S 文件主要负责执行以下任务:
-
清空 bss 段:start.S 文件会在启动时清空操作系统内核中未初始化的 bss 段,这样就可以避免未初始化变量带来的问题。
-
设置初始内核栈:该文件还会设置初始的内核栈,用于处理操作系统内核启动期间的各种中断和异常。
-
调整 CPU 模式和特权级:start.S 文件还会将 CPU 的模式调整为特权级模式,并将特权级设置为最高级别,以便能够访问所有的内存和硬件资源。
-
启动 MMU 和缓存:start.S 文件还会启动内存管理单元(MMU)和 CPU 缓存,以提高操作系统内核的运行速度。
start_kernel 是 Linux 操作系统内核的一个主要函数,它包含了操作系统内核在启动时的大部分初始化代码和任务,是整个内核启动过程的起点。
具体来说,start_kernel 函数主要完成以下工作:
- 初始化内核的全局变量:首先,start_kernel 函数会初始化内核的全局变量,包括 CPU ID、操作系统内核版本、内核命令行参数等。
- 设置内核的基本参数:该函数还会设置内核的一些基本参数,包括时钟参数、中断控制器参数、内存管理参数等。
- 初始化内核的子系统:start_kernel 函数还会初始化内核的各个子系统,例如进程管理子系统、文件系统子系统、网络协议栈子系统等。
- 启动 idle 进程:该函数还会启动 idle 进程,这是操作系统内核唯一的用户进程,当系统没有其他任务需要运行时,idle 进程会占用 CPU,并执行空循环等待下一个任务的到来。
- 启动 init 进程:最后,start_kernel 函数会启动 init 进程,这是操作系统内核用户模式下执行的第一个进程。init 进程会读取系统配置文件,并启动其他用户进程和服务。
总之,start_kernel 是 Linux 操作系统内核的主函数之一,它完成了内核的启动和初始化。当 start_kernel 函数执行完毕后,操作系统内核就已经准备好了,可以开始处理用户的请求,并提供各种功能和服务。
原文链接:https://blog.csdn.net/m0_74282605/article/details/128132589
rootfs根文件系统
首先要明白的是“什么是文件系统”,文件系统是对一个存储设备上的数据和元数据进行组织的机制。这种机制有利于用户和操作系统的交互。
根文件系统首先是内核启动时所mount的第一个文件系统,内核代码映像文件保存在根文件系统中,而系统引导启动程序会在根文件系统挂载之后从中把一些基本的初始化脚本和服务等加载到内存中去运行。
根文件系统之所以在前面加一个”根“,说明它是加载其它文件系统的”根“,既然是根的话,那么如果没有这个根,其它的文件系统也就没有办法进行加载的。它包含系统引导和使其他文件系统得以挂载(mount)所必要的文件。根文件系统包括Linux启动时所必须的目录和关键性的文件,例如Linux启动时都需要有init目录下的相关文件,在 Linux挂载分区时Linux一定会找/etc/fstab这个挂载文件等,根文件系统中还包括了许多的应用程序bin目录等,任何包括这些Linux 系统启动所必须的文件都可以成为根文件系统。
Linux启动时,第一个必须挂载的是根文件系统;若系统不能从指定设备上挂载根文件系统,则系统会出错而退出启动。成功之后可以自动或手动挂载其他的文件系统。因此,一个系统中可以同时存在不同的文件系统。
在 Linux 中将一个文件系统与一个存储设备关联起来的过程称为挂载(mount)。使用 mount 命令将一个文件系统附着到当前文件系统层次结构中(根)。在执行挂装时,要提供文件系统类型、文件系统和一个挂装点。根文件系统被挂载到根目录下“/”上后,在根目录下就有根文件系统的各个目录,文件:/bin /sbin /mnt等,再将其他分区挂接到/mnt目录上,/mnt目录下就有这个分区的各个目录,文件。
Linux根文件系统中一般有如下的几个目录:
1./bin目录
该目录下的命令可以被root与一般账号所使用,由于这些命令在挂接其它文件系统之前就可以使用,所以/bin目录必须和根文件系统在同一个分区中。
/bin目录下常用的命令有:cat、chgrp、chmod、cp、ls、sh、kill、mount、umount、mkdir、[、test等。其中“[”命令就是test命令,我们在利用Busybox制作根文件系统时,在生成的bin目录下,可以看到一些可执行的文件,也就是可用的一些命令。
2./sbin 目录
该目录下存放系统命令,即只有系统管理员(俗称最高权限的root)能够使用的命令,系统命令还可以存放在/usr/sbin,/usr/local/sbin目录下,/sbin目录中存放的是基本的系统命令,它们用于启动系统和修复系统等,与/bin目录相似,在挂接其他文件系统之前就可以使用/sbin,所以/sbin目录必须和根文件系统在同一个分区中。
/sbin目录下常用的命令有:shutdown、reboot、fdisk、fsck、init等,本地用户自己安装的系统命令放在/usr/local/sbin目录下。
3、/dev目录
该目录下存放的是设备与设备接口的文件,设备文件是Linux中特有的文件类型,在Linux系统下,以文件的方式访问各种设备,即通过读写某个设备文件操作某个具体硬件。比如通过"dev/ttySAC0"文件可以操作串口0,通过"/dev/mtdblock1"可以访问MTD设备的第2个分区。比较重要的文件有/dev/null, /dev/zero, /dev/tty, /dev/lp*等。
4./etc目录
该目录下存放着系统主要的配置文件,例如人员的账号密码文件、各种服务的其实文件等。一般来说,此目录的各文件属性是可以让一般用户查阅的,但是只有root有权限修改。对于PC上的Linux系统,/etc目录下的文件和目录非常多,这些目录文件是可选的,它们依赖于系统中所拥有的应用程序,依赖于这些程序是否需要配置文件。在嵌入式系统中,这些内容可以大为精减。
5./lib目录
该目录下存放共享库和可加载(驱动程序),共享库用于启动系统。运行根文件系统中的可执行程序,比如:/bin /sbin 目录下的程序。
6./home目录
系统默认的用户文件夹,它是可选的,对于每个普通用户,在/home目录下都有一个以用户名命名的子目录,里面存放用户相关的配置文件。
7./root目录
系统管理员(root)的主文件夹,即是根用户的目录,与此对应,普通用户的目录是/home下的某个子目录。
8./usr目录
/usr目录的内容可以存在另一个分区中,在系统启动后再挂接到根文件系统中的/usr目录下。里面存放的是共享、只读的程序和数据,这表明/usr目录下的内容可以在多个主机间共享,这些主要也符合FHS标准的。/usr中的文件应该是只读的,其他主机相关的,可变的文件应该保存在其他目录下,比如/var。/usr目录在嵌入式中可以精减。
9./var目录
与/usr目录相反,/var目录中存放可变的数据,比如spool目录(mail,news),log文件,临时文件。
10./proc目录
这是一个空目录,常作为proc文件系统的挂接点,proc文件系统是个虚拟的文件系统,它没有实际的存储设备,里面的目录,文件都是由内核
临时生成的,用来表示系统的运行状态,也可以操作其中的文件控制系统。
11./mnt目录
用于临时挂载某个文件系统的挂接点,通常是空目录,也可以在里面创建一引起空的子目录,比如/mnt/cdram /mnt/hda1 。用来临时挂载光盘、移动存储设备等。
12. /tmp目录
用于存放临时文件,通常是空目录,一些需要生成临时文件的程序用到的/tmp目录下,所以/tmp目录必须存在并可以访问。
总结如下:
什么是rootfs,为什么需要rootfs?
内核启动后会开启三个进程,分别是:
进程0(idle进程),空闲进程,也就是死循环
进程1(init进程),挂载根文件系统,并执行Linuxrc这个应用程序从内核态转为用户态,开启用户态的进程1(init进程),逐步开启其他进程
进程2(kthread进程)linux内核的守护进程,负责提供操作系统的核心功能(进程调度、内存管理、设备管理、文件系统)的实现
根文件系统的作用:
(1)init进程的应用程序(Linuxrc)在根文件系统上
(2)根文件系统提供了根目录/
(3)内核启动后的应用层配置(etc目录)在根文件系统上。几乎可以认为:发行版=内核+rootfs
(4)shell命令程序在根文件系统上。譬如ls、cd等命令
(5)/lib目录下的库文件等
所以:一套linux体系,只有内核本身是不能工作的,必须要rootfs
原文链接:https://blog.csdn.net/gysmmzh/article/details/53422731
从整个嵌入式软件架构层次看,rootfs是属于Linux基础运行环境的一部分,属于BSP负责范围。从产品开发角度看,为了减少组件的维护成本,BSP一般只维护uboot和kernel image两个组件,将rootfs以initramfs的方式打入到kernel image里面,也自然需要BSP负责。另外,如果交给应用层开发人员维护rootfs,就要求他们掌握更多关于系统启动、系统参数配置、设备节点管理、文件系统、分区挂载等嵌入式底层相关细节,不利于专业分工。
所以,rootfs应该由BSP来负责,而且要尽可能保证不同产品、平台、单板上BSP组件调用APP组件的接口(挂载应用分区、验证并启动应用程序引导启动脚本)一致。
原文链接:https://www.zhihu.com/topic/25400639/top-answers
devicestree文件配置及makefile语法
术语介绍:
1,DTS(Device Tree Source):设备树源码。为方便阅读和修改,设备树源文件遵循一定的格式,采用文本方式存放。
2,DTB(Device Tree Blob):设备树对象。DTS的二进制对象表示形式,通过DTC将DTS编译成DTB。
3,DTC(Device Tree Compiler):设备树编译器。kernel提供的一个小工具,可以将 DTS 编译成 DTB。
DTB文件是Device Tree Blob的缩写,由DTS(设备树源文件)编译而成的二进制格式文件,用于在Linux系统中描述硬件配置信息,由Bootloader加载至内核以实现硬件驱动匹配。
DTB全称为Device Tree Blob,是DTS(Device Tree Source)文本文件通过DTC(Device Tree Compiler)工具编译后生成的二进制文件。其核心功能是以结构化数据描述硬件资源,包括CPU、内存、中断控制器、外设等,使操作系统无需依赖特定硬件平台代码即可识别设备。文件格式由四部分组成:头部(`fdt_header`)、内存保留块(`memory reservation block`)、结构块(`structure block`)和字符串块(`strings block`),其中结构块存储节点信息,字符串块存储属性名称。
在嵌入式Linux系统中,DTB文件的核心用途包括:
1. 硬件抽象与驱动匹配:Bootloader将DTB加载到内存后,内核解析其内容,自动匹配设备驱动,避免硬编码硬件参数。
2. 运行时配置:定义内存保留区域(如`/memreserve/`)和启动参数(如`/chosen/bootargs`),确保关键资源不被动态分配覆盖。
3. 跨平台兼容性:通过统一描述硬件,支持同一内核镜像在不同硬件底板运行,例如在RK3399或OrangePi等设备上解决屏幕闪烁或分辨率问题。
DTB作为二进制文件需专用工具处理:
1. 编译与反编译:
- 使用DTC工具将DTS编译为DTB:`dtc -I dts -O dtb -o output.dts input.dts`。
- 反编译DTB为可编辑的DTS:`dtc -I dtb -O dts -o output.dts input.dtb`。
2. 修改与生效:开发中需修改DTS后重新编译DTB,并通过Bootloader(如U-Boot)更新至设备,例如华为Atlas模块使用`build.sh dtb`生成`dt.img`文件。
3. 查看工具:二进制编辑器(如UltraEdit)可解析DTB结构,但推荐反编译为DTS后文本编辑。
问题:相同的dtsi文件配置,在同一批次的硬件上会不会出现效果或者性能有所差异?
在同一批次的硬件上,相同的dtsi文件配置理论上应该不会出现效果或者性能有所差异的情况。因为同一批次的硬件应该是由同样的生产工艺、原材料和生产设备制造生产的,因此硬件特性、功能和性能应该是相同的。
当然,如果同一批次的硬件存在质量问题,如制造过程中出现了误操作、材料选择不当或工艺不正确等错误,那么可能会导致相同的dtsi文件配置在这些硬件上产生差异,例如某些设备不能正常工作、性能下降或出现异常等情况。但这种情况应该是非常罕见的,只有在生产出现重大问题或者硬件本身存在缺陷时才会发生。
因此,在设计嵌入式系统时,需要仔细考虑硬件平台的稳定性和可靠性,确保在同一批次的硬件上可以获得一致的性能和功能表现。另外,也需要进行充分的测试和验证工作,以发现潜在的硬件问题,保证系统的稳定性和可靠性。
原文链接:https://blog.csdn.net/xiaopangzi313/article/details/52331931
https://blog.csdn.net/weixin_33850015/article/details/91871179
通讯协议(UART、SPI、I2C、TCP\IP)

1. 硬件连接:
- SPI:用 4 根线(时钟 SCLK、主输出从输入 MOSI、主输入从输出 MISO、片选 SS),布线较复杂。
- I2C:只用 2 根线(数据 SDA、时钟 SCL),节省空间但需上拉电阻。
- UART:用 2 根线(发送 TX、接收 RX),最简单但需严格匹配波特率。
2. 总线速度:
- SPI 最快:最高 10Mbps,适合高速传输(如 Flash 存储器、屏幕显示)。
- I2C 中等:最高 3.4Mbps,适合中低速设备(如温度传感器、EEPROM)。
- UART 最慢:常见 115200bps,仅用于调试或简单通信(如串口打印)。
3. 总线拓扑:
- SPI:可以支持一对多的连接方式,其中一个主设备可以控制多个从设备。
- I2C:使用多主机和从机的方式,可以有多个主设备和多个从设备连接在同一条总线上。
- UART:通常是点对点的,只支持一个发送器和一个接收器。
4. 通信方式:
- SPI:同步通信(需时钟线),全双工(同时收发数据),主从控制。
- I2C:同步通信(需时钟线),半双工(不能同时收发),支持多主多从。
- UART:异步通信(无时钟线),全双工,点对点连接。
5. 功能:
- SPI:在数据传输方面非常灵活,并且可以支持双向、全双工或半双工模式。
- I2C:具有广泛的设备支持和多种设备可以共享同一条总线的能力。
- UART:主要用于串行数据传输,通常用于简单的单向或双向串行通信。
单工,半双工,全双工:
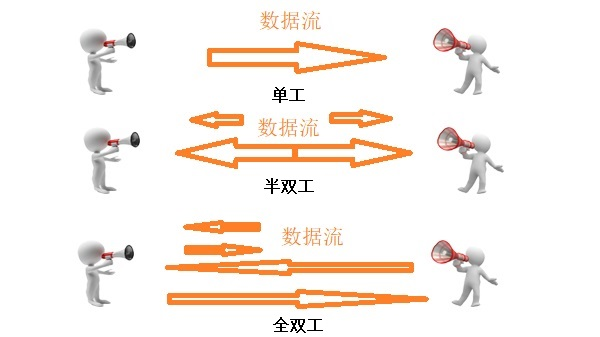
单工(Simplex):单工通信只允许信息在一个方向上进行传输。发送方和接收方在通信中扮演固定的角色,发送方只能发送数据,而接收方只能接收数据。这种通信方式类似于广播,其中一方发送信息,而另一方只能接收信息,而不能回复。
半双工(Half Duplex):半双工通信允许信息在两个方向上进行传输,但不能同时进行。发送方和接收方可以交替地发送和接收数据,但在任何给定的时间内,只能有一个方向上的传输。当一方发送数据时,另一方必须等待,而不能同时发送数据。这种通信方式类似于对讲机。
全双工(Full Duplex):全双工通信允许信息在两个方向上同时进行传输。发送方和接收方可以同时发送和接收数据,因此在通信中可以实现双向传输,无需等待。这意味着发送和接收可以同时进行,提高了通信效率。这种通信方式类似于电话。
在全双工通信中,通信双方需使用独立的信道或信号线来进行发送和接收,以避免冲突。相比之下,半双工通信只需要使用一个信道或信号线来进行交替的发送和接收,因此可能会出现一定程度的冲突。单工通信只允许单一方向上的数据传输,因此通信效率相对较低。选择适当的通信模式取决于具体的应用场景和通信需求。

同步传输和异步传输:
1. 同步传输:同步传输是一种基于时钟信号进行数据传输的方式。发送方和接收方在数据传输之前需要保持时钟的同步。数据的传输速率是根据时钟信号的频率来确定的,发送方和接收方都严格按照时钟信号的边沿来进行数据的采样和发送。常见的同步传输协议包括SPI(Serial Peripheral Interface)、I2C(Inter-Integrated Circuit)和SDI(Serial Data Interface)等。
2. 异步传输:异步传输是一种不依赖于固定时钟信号的数据传输方式。在异步传输中,每个数据帧具有独立的起始标志和停止标志,以标识一个完整的数据帧。发送方和接收方之间的数据传输速率不需要保持精确的同步。常见的异步传输协议包括UART(Universal Asynchronous Receiver/Transmitter)和USB(Universal Serial Bus)等。
主要区别如下:
同步传输依赖于时钟信号,而异步传输不依赖于时钟信号。
同步传输的传输速率受到时钟频率的限制,而异步传输的传输速率可以根据需求进行调整。
同步传输要求发送方和接收方保持时钟同步,而异步传输不需要时钟同步。
同步传输通常用于短距离高速数据传输,而异步传输通常用于串行通信和较长距离的数据传输。
串行和并行:
1. 串行传输:串行传输是一种按照顺序逐位传输数据的方式。在串行传输中,数据位逐个按照一定的顺序进行传输,每一位数据都需要依次传输完毕,然后再传输下一位数据。因此,串行传输只使用一条信号线或通道进行数据传输。串行传输的优势在于可以减少所需的物理连接数目,适用于较长距离传输和对线路复杂性要求较低的场景。常见的串行传输接口包括串行总线接口(如I2C、SPI)和串行通信协议(如RS-232)等。
2. 并行传输:并行传输是一种通过多条信号线或通道同时传输多个数据位的方式。在并行传输中,数据被分成多个数据位,并通过多条信号线同时传输。每个数据位通过一个独立的信号线进行传输,从而实现多个数据位的同时传输。并行传输的优势在于传输速度较快,适用于对传输速度要求较高的场景。然而,由于每个数据位需要独立的信号线,因此并行传输会增加所需的物理连接数目和线路复杂性,尤其在距离较远时会更加复杂。常见的并行传输接口包括传统的并行端口(如打印机接口)和内部总线(如PCIe)等。
串行传输和并行传输的主要区别在于数据传输的方式和使用的信号线数量。
1. 数据传输方式:串行传输是逐位传输数据的方式,即一次只传输一个数据位,按照固定的顺序逐位传输;而并行传输是同时传输多个数据位的方式,多个数据位通过独立的信号线同时传输。
2. 信号线数量:串行传输只使用一条信号线(或通道)进行数据传输,每次传输仅传输一个数据位;而并行传输需要使用多条平行的信号线进行数据传输,每组信号线对应一个数据位,多个数据位通过各自的信号线同时传输。
3. 传输速度:由于并行传输同时传输多个数据位,传输速度通常比串行传输更快。然而,并行传输的速度受到线路延迟和同步问题的影响,而串行传输则可以更容易地实现较高的传输速度。
4. 线路复杂性:并行传输需要使用多条信号线,因此在物理上需要更多的连接和布线,导致线路复杂性增加;而串行传输只需要较少的信号线,因此线路布线相对较简单。
串行传输是逐位传输数据的方式,适用于长距离传输和对线路复杂性要求较低的场景;而并行传输是同时传输多个数据位的方式,适用于要求高传输速度的场景,但会增加线路复杂性。具体选择串行传输还是并行传输,需要考虑具体的应用需求和系统架构。
【问题】在多主多从环境下,是怎么实现主设备和从设备的传输的?主设备是否可以切换为从设备?
I²C协议支持多主设备架构,其中任意时刻仅有一个主设备;所有设备(包括主设备)均可配置为从设备角色。I²C总线通过主从架构、唯一地址寻址、时钟同步和总线仲裁机制,在多主多从环境中实现特定主从设备间的可靠通信。
当多个主设备同时尝试通信时,I²C的总线仲裁机制通过线与逻辑(SDA线)检测数据冲突:主设备在发送数据位时同时监测SDA线,若实际电平与发送不一致(即“丢失仲裁”),则自动切换为从设备并释放总线,仲裁失败的设备不会干扰总线,成功设备继续传输;
当主设备与多个从设备尝试通信时, I²C通过唯一地址寻址找到所需要的从设备:I²C使用SDA(数据线)和SCL(时钟线)两条线路,所有设备共享同一总线;每个从设备拥有唯一的7位或10位地址,主机通过发送地址帧(包含目标从设备地址和读/写控制位)来选择通信对象,地址匹配的从设备响应ACK信号,未匹配的则返回NACK,从而实现软件寻址。
设备可动态切换主从角色,但需软件协调。 例如,一个MCU可常规作为主设备轮询从机,当收到上位机配置请求时,通过软件将I²C接口配置为从设备模式并监听总线地址;切换本质是软件行为,硬件支持多主仲裁,但需避免总线竞争。
原文链接:https://xiefor100.blog.csdn.net/article/details/65445338
https://blog.csdn.net/chenpuo/article/details/81023882
https://jylin.blog.csdn.net/article/details/131776468
交叉编译
为什么需要交叉编译呢?
有时是因为目的平台上不允许或不能够安装我们所需要的编译器,而我们又需要这个编译器的某些特征;有时是因为目的平台上的资源贫乏,无法运行我们所需要编译器;有时又是因为目的平台还没有建立,连操作系统都没有,根本谈不上运行什么编译器。
交叉编译的基本流程如下:
- 配置交叉编译工具链:交叉编译工具链包括编译器、链接器、头文件和库等,需要根据不同的目标平台和开发平台进行相应的配置。
- 编写源代码:在开发平台上使用适合交叉编译器的编程语言(如C、C++、汇编等)编写源代码。
- 交叉编译:使用交叉编译工具链对源代码进行编译、连接和优化,生成适合目标平台的可执行文件。
- 调试和测试:在目标平台上进行调试和测试,以确保软件能够正常运行并满足需求。
需要注意的是,在进行交叉编译时,需要考虑到不同平台之间的差异性,如字节序、寄存器结构、库文件等,避免因为平台差异而导致编译出的可执行文件无法在目标平台上运行。因此,在进行交叉编译前,需要仔细考虑目标平台和开发平台的差异,并根据实际情况进行相应的配置和调整。
常见的交叉编译例子有:
1. 在PC上编译ARM嵌入式系统的应用程序:使用arm-none-linux-gnueabi-gcc交叉编译工具。
2. 在PC上编译MIPS嵌入式系统的应用程序:使用mipsel-linux-gnu-gcc交叉编译工具。
3. 在Windows上编译Linux应用程序:使用MinGW交叉编译工具。
4. 在Windows上编译Android应用程序:使用Android NDK交叉编译工具。
5. 在Mac上编译iOS应用程序:使用Xcode IDE中的Clang编译器和SDK进行交叉编译。
交叉编译需要在开发者所在的平台上安装相应的交叉编译工具链,并进行配置后才能进行。交叉编译在嵌入式系统、移动设备、云计算等领域中得到广泛应用,可以快速地生成可在目标平台上运行的程序,提高了软件开发的效率和代码的可移植性。
中断
中断是计算机处理器(CPU)中的一种机制,用于实现异步事件的响应和处理。当外部设备需要通知处理器发生了某个事件时,会采用中断方式向处理器发送信号,使处理器暂停当前正在执行的进程,转而去执行与中断相对应的中断处理程序。中断可以让计算机实现多任务处理,提高计算机系统的效率和响应速度。
在Linux系统中,中断分为硬件中断和软件中断两种类型。
硬件中断通常是来自外部设备的信号,例如键盘、鼠标、网卡等设备。当外部设备执行某个操作时,会向处理器发送中断请求信号。处理器接收到中断请求后,停止当前的任务运行,并执行与中断相关联的中断处理程序。中断处理程序会对设备进行处理,处理完成后将程序控制权交还给原始的进程,恢复进程执行。
硬件中断的实现是通过中断控制器和中断向量表来完成的。中断控制器负责接收和管理中断请求,中断向量表则记录了每个中断源的中断处理程序地址。当处理器接收到中断请求时,中断控制器会将中断请求发送给处理器,并根据中断号查找中断向量表中相应的中断处理程序执行。
硬件中断通常可以分为外部中断、内部中断和异常中断三种类型。
- 外部中断:来自计算机系统外部设备的信号所引起的中断,例如键盘、鼠标、网卡等外设发生了一些特定的事件时会产生外部中断。这种中断是由中断控制器负责管理和分配的,是计算机系统与外部设备之间进行通信的重要途径。
- 内部中断:来自CPU内部的信号引起的中断,例如时钟中断、I/O端口中断等。这种中断不需要外部设备产生中断请求信号,而是由计算机本身内部的硬件部件或者外部硬件设备的指令序列产生的,是计算机硬件组件之间协调工作的必要手段。
- 异常中断:也称为特殊中断,是由于执行指令过程中遇到意外的情况(如算术溢出、非法指令、内存地址越界等)而产生的中断。这种中断是CPU内部的错误处理机制,当CPU遇到异常情况时会停止正常执行流程,并转而执行异常处理程序进行处理。
软件中断是由软件程序触发的中断,例如系统调用、定时器中断等。在Linux系统中,软件中断通常被称为“内核中断”,它们是由内核线程触发和处理的。内核线程会在固定的时间间隔内启动定时器中断程序,以在特定时间执行一些任务,例如更新系统运行状态、进行内存管理等。
需要注意的是,软件中断和硬件中断不同,它不是由外部设备产生的中断信号,而是由内核自身发起的中断请求。因此,在触发软件中断时,不需要像硬件中断那样通过中断控制器进行中断分发和管理,而是直接通过中断向量表查找和执行中断处理程序。
软件中断通常分为系统调用、软中断和定时器中断三类。
- 系统调用:是由用户空间的应用程序向内核发出的请求,请求内核完成某些特定的操作,例如打开、关闭文件、读写文件等。系统调用可以看作是用户空间与内核空间之间的接口,提供了一种安全、可靠的方式让应用程序访问底层系统资源和服务。
- 软中断:是由内核内部的软件组件产生的一种中断,用于实现内核线程之间的通信和协调。软中断通常会在内核的上下文中触发,并执行一些短暂的任务,例如更新内存管理信息、处理网络数据包等。软中断相对于硬中断来说,具有更低的延迟和更高的效率,因此在内核编程中被广泛使用。
- 定时器中断:是由定时器硬件产生的一种中断,可以周期性地触发内核中的任务,例如更新系统状态、删除过期进程等。定时器中断通常会在内核上下文中被处理,因此可以保证高效和精确。
除了这三种常见的软件中断之外,还有一些其他类型的软件中断,例如信号中断、IRQ(Interrupt Request)线程、workqueue等都是在Linux内核中常见的软件中断处理机制。
总之,中断是Linux系统中非常重要的机制之一,用于处理外设事件和操作系统内部事件,提高计算机的响应速度和效率。
当CPU接收到中断请求时,它会进行以下操作:
- 中断处理器暂停当前正在执行的进程,将控制权转移到中断处理程序。
- 保存当前进程的上下文信息,包括程序计数器、寄存器等,以备恢复时使用。
- 确定中断源,并查找与之相关联的中断处理程序。
- 执行中断处理程序,对中断源进行处理。
- 恢复被中断的进程的上下文信息并继续执行。这个过程称为中断返回。
中断向量表(Interrupt Vector Table)是一个固定长度的数据结构,用于存储中断处理程序的入口地址,以响应和处理硬件中断和软件中断。
在x86架构的计算机系统中,中断向量表是一个长度为256个元素的数组(0-255),其中每个元素都包含了一个指向中断处理程序的函数指针。具体而言,中断向量表中存储了如下内容:
- 中断处理程序入口地址:每个元素都包含一个指向中断处理程序的C函数指针,该函数用于响应和处理对应中断号的中断请求。当中断请求发生时,CPU会根据中断号查询中断向量表,并跳转到对应的中断处理程序入口地址开始执行相应的处理代码。
- 中断门描述符:中断门描述符是一种特殊的数据结构,用于描述中断处理程序的属性和状态。它包含了中断类型、DPL(Descriptor Privilege Level)、代码段选择子、中断处理程序入口等重要信息,用于实现安全和可靠的中断处理。
- 系统调用号:在Linux系统中,中断向量表中还包含了一些用于系统调用的特定中断号,例如sysenter和int 80h等,用于实现用户空间与内核空间之间的接口。
由于中断向量表的内容非常重要,因此在操作系统的设计和开发中需要特别注意其正确性和安全性,以确保系统的稳定和可靠运行。
问题:中断能不能进行大数据量的传输?
中断不适合进行大数据量的传输,因为中断是一个异步的、无法预测的事件响应机制,它的执行时间是不可控的,而且频繁地触发中断会对系统性能产生较大影响。如果在中断处理程序中执行大数据量的传输,将会导致中断处理时间过长,从而影响系统的响应速度和稳定性。
相对于中断,数据传输应该放在系统的正常运行流程中完成。操作系统通常采用I/O端口、DMA(直接内存访问)等机制来实现大数据量的传输。其中,DMA可以在不占用CPU时间的情况下,通过直接访问内存进行数据传输,具有高效、稳定的特点,适合用于大数据量的传输。
当然,在某些场景下,中断也可以用于进行少量数据的传输,例如一个字符或一个单词等。但对于大数据量的传输,还是需要采用其他的机制来进行,以保证系统的性能和稳定性。
Linux用户空间与内核空间交互的几种方式
对于进程来说,它既有内核空间(与其他进程共享),也有用户空间(进程私有私有)。不
管是内核空间还是用户空间,它们都处于虚拟地址空间。
内核空间和用户空间交换数据的方式有很多。用户空间发起的有系统调用、proc、虚拟文
件系统等。内核空间主动发起的有get_user/put_user、信号、netlink等。
Linux应用程序与内核程序交互主要有以下几种通信方式:
(1)系统调用
Linux系统下,设备即文件,也因此大部分设备驱动程序都实现了标准的系统接口,如:
● open(),read(),write(), ioctl(), mmap()
● get_user(x,ptr):在内核中被调用,获取用户空间指定地址的数值并保存到内核变量x中。
● put_user(x,ptr):在内核中被调用,将内核空间变量x的数值保存到到用户空间指定地址处
● Copy_from_user() / copy_to_user():主要应用于设备驱动读写函数中,通过系统调用触发
(2)虚拟文件系统
● proc文件系统
● sysfs文件系统
● debugfs文件系统
很多内核程序细节,如中断等,都在proc/目录下有所体现,虚拟文件系统提供了一种便捷的
用户空间和内核空间的交互方式;
(3)内存映像
mmap共享内存。Linux通过mmap的把内核中特定部分的内存空间映射到用户级程序的内存
空间去,从而提供了用户程序对内存直接访问的能力。该方式尤其适合在那些内核和用户空间需要
快速大量交互数据的情况下,如framebuffer设备。
(4)内核程序使用信号通知应用程序
信号在内核里的用途主要集中在通知用户程序出现重大错误,强行杀死当前进程,这时内核
通过发送SIGKILL信号通知进程终止。
信号发送必须要事先知道进程序号(pid),所以要想从内核中通过发信号的方式异步通
知用户进程执行某项任务,那么必须事先知道用户进程的进程号才可以(可以让应用程序通过oictl
函数,把自己的PID主动告诉驱动程序)。而一般内核运行时搜索特定进程的进程号是个费事的工
作,可能要遍历整个进程控制块链表。所以用信号通知特定用户进程的方法很糟糕,一般在内核不
会使用。内核中使用信号的情形只出现在通知当前进程(可以从current变量中方便获得pid)做某
些通用操作,如终止操作等。因此对内核开发者该方法用处不大。类似情况还有消息操作。
(5)从内核空间回调用户程序。
(6)netlink
原文链接:https://blog.csdn.net/lpwsw/article/details/121924000
设备驱动分为三大类:字符设备、块设备、网络设备
1.字符设备
对数据的处理按照字节流的形式进行的,支持顺序访问(是有时间的概念),也可以支持随机访问
典型的字符设备:串口、键盘、触摸屏、摄像头、I2C、SPI、声卡、帧缓冲设备
顺序访问的设备:串口、键盘、触摸屏
随机访问的设备:帧缓冲设备
2.块设备
对数据的处理按照若干个块来进行的。一个块的固定大小512字节、4096字节。这类设备支持随机访问,这种以块和随机访问能够提高数据存储效率。
块设备往往是面向于存储类的设备: nand flash、SD卡、U盘、eMMC、硬盘
3.网络设备
网络设备是比较特殊的,在/dev没有设备文件,它就是专门针对网络设备的一类驱动,其主要作用是进行网络的数据收发。
网络类设备:有线网卡、无线WiFi网卡(RT3070)、无线GPRS网卡、无线4G网卡
应用程序:socket套接字
原文链接:https://blog.csdn.net/qq_45698138/article/details/128506897
字符设备驱动开发步骤:
1. 驱动模块的加载和卸载
module_init(xxx_init); //注册模块加载函数
module_exit(xxx_exit); //注册模块卸载函数
module_init函数用来向 Linux内核注册一个模块加载函数,参数 xxx_init就是需要注册的具体函数,当使用“ insmod”命令加载驱动的时候 xxx_init这个函数就会被调用,一般在xxx_init函数里进行一些驱动的初始化工作。
module_exit()函数用来向 Linux内核注册一个模块卸载函数,参数 xxx_exit就是需要注册的具体函数,当使用“ rmmod”命令卸载具体驱动的时候 xxx_exit函数就会被调用,在xxx_exit里面就需要对驱动程序的卸载做一些回收工作。
2. 字符设备注册与注销
static inline int register_chrdev(unsigned int major, const char *name, const struct file_operations *fops)
static inline void unregister_chrdev(unsigned int major, const char *name)
register_chrdev函数用于注册字符设备,此函数共有三个参数:
- major:主设备号,linux每个设备都有一个设备号,设备号分为主设备号和次设备号。
- name:设备名字,指向一串字符串。
- fops:结构体file_operations类型指针。
unregister_chrdev函数用于注销字符设备,此函数共有两个参数:
- major:要注销的设备对应的主设备号。
- name:要注销的设备对应的设备名。
3. 实现设备的具体操作函数
对具体设备驱动功能实现需要分析其需求,也就是构造file_operation结构体,对file_operations结构体成员进行实例化。
//初始化file_operations结构体
static struct file_operations test_fops=(void)
{
	.owner = THIS_MODULE,
	.open = chrtest_open,
	.read = chrtest_read,
	.write = chrtest_write,
	.release = chrtest_release,
};
4. 设备号的分配
为了方便管理, Linux中每个设备都有一个设备号,设备号由主设备号和次设备号两部分组成,主设备号表示某一个具体的驱动,次设备号表示使用这个驱动的各个设备。 Linux提供了一个名为 dev_t的数据类型表示设备号, dev_t定义在文件 include/linux/types.h里面,定义如下:
typedef __u32 __kernel_dev_t;
typedef __kernel_dev_t dev_t;
可以看出 dev_t是 __u32类型的,而 __u32定义在文件 include/uapi/asm-generic/int-ll64.h里面,定义如下:
typedef unsigned int __u32;综上所述, dev_t其实就是 unsigned int类型,是一个 32位的数据类型。这 32位的数据构成了主设备号和次设备号两部分,其中高12位为主设备号, 低 20位为次设备号。因此 Linux系统中主设备号范围为 0~4095,所以大家在选择主设备号的时候一定不要超过这个范围。
4.1静态分配设备号
静态分配号,可以由开发者自己确定设备号,但是会有可能指定到一个正在使用的设备号,这是静态分配设备号的缺点。在确定设备号前,可以先查看设备号是否被使用,可以用cat /proc/devices查看。
int register_chrdev_region(dev_t from, unsigned count, const char *name)- from:要释放的设备号
- count:表示从from开始,要释放的设备号数量
- name:设备名字
4.2动态分配设备号
动态分配设备号有系统分配一个未被使用的设备号,这样也就不会造成冲突了,但是缺点就是分配之后的设备号到底是多少,是不确定的。
int alloc_chrdev_region(dev_t *dev,unsigned baseminor,unsigned count,const char *name)- dev: 保存申请到的设备号
- baseminor:此设备号的起始地址,alloc_chrdev_region可以申请到一端连续的多个设备号,这些设备号的主设备号都一样,但是次设备号不同,次设备号以baseminor为起始地址开始递增。一般baseminor为0,所以说此设备号从0开始。
- count:要申请的设备号数量。
void unregister_chrdev_region(dev_t from,unsigned count)原文链接:https://blog.csdn.net/DRAXY/article/details/126117144
块设备驱动的编写
块设备驱动开发步骤:
块设备驱动程序的编写流程同字符设备驱动程序的编写流程很类似,也包括了注册和使用两部分。但与字符驱动设备所不同的是,块设备驱动程序包括一个request请求队列。它是当内核安排一次数据传输时在列表中的一个请求队列,用以最大化系统性能为原则进行排序。
1. 块设备驱动程序注册
块设备要想被内核知道其存在,必须使用内核提供的一系列注册函数进行注册。驱动程序的第一步就是向内核注册自己,提供该功能的函数是
int register_blkdev(unsigned int major, const char *name);- 参数是该设备使用的主设备号及其名字,name通常与设备文件名称相同,但也可以是任意有效的字符串。
- 如果传递的主设备号是0,内核将分派一个新的主设备号给设备,并将该设备号返回给调用者。
- 使用该函数,块设备将会显示在/proc/devices。
对应的注销函数为
int unregister_blkdev(unsigned int major, const char *name);2. 磁盘注册
通过注册驱动程序我们获得了主设备号,但是现在还不能对磁盘进行操作。内核对于磁盘的表示是使用的gendisk结构体, gendisk结构中的许多成员必须由驱动程序进行初始化。
gendisk结构是一个动态分配的结构,它需要一些内核的特殊处理来进行初始化;驱动程序不能自己动态分配该结构,而是必须调用alloc_disk(),参数是该磁盘使用的次设备号数目。
分配一个gendisk结构并不能使磁盘对系统可用。为达到这个目的,必须初始化结构,并调用add_disk。Gendisk中包含了一个指针struct block_ device_ operations * fops ;指向对应的块设备操作函数,接下来看一下block_ device_ operations都有哪些函数需要驱动程序来实现。
3. 块设备操作
字符设备使用file__operations结构告诉系统对它们的操作接口。块设备使用类似的数据结构,在<linux/fs.h>中声明了结构block_ device_ operations。同时块设备在VFS层也提供了统一的标准操作结构file_ operations。
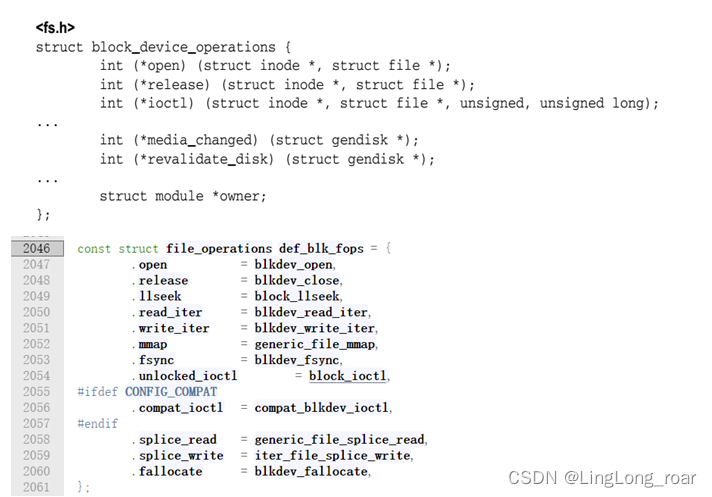
open、release和ioctl 与file_ operations中 等价函数的语义相同, 分别用于打开、关闭文件以及向块设备发送特殊命令(查询设备物理信息,扇区,磁头数)。
4. 请求队列
块设备的读写请求放置在一个队列上,称之为请求队列。gendisk结构包括了一个指针,指向这个特定于设备的队列,由以下数据类型表示。
queue_ head是该数据结构的主要成员,是一个表头,用于构建一个I/O请求的双链表。 链表每个元素的数据类型都是request,代表向块设备读取数据的一个请求。
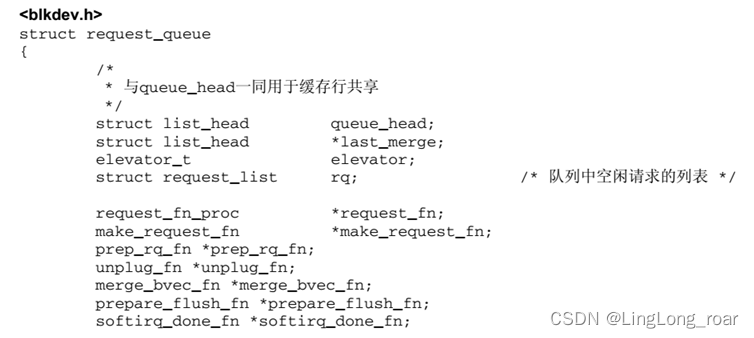
我们需要为gendisk创建并初始化对应的请求队列,函数如下:
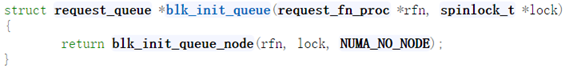
该函数的参数是一个需要驱动实现的函数,用来处理该队列中的request和控制访问队列权限的自旋锁。
5. 请求处理
请求队列创建初始化如下所示:

其中request的处理函数my_request编写如下: 主要实现的功能有:
- 使用blk_fetch_request函数获取队列中的request,循环处理队列中的request。
- 获取请求的起始地址与读写扇区数。
- 根据读写的请求不同,分别处理。(因为是用内存模拟的设备,使用memcpy函数直接拷贝数据)
6. 编译加载驱动
编写对应的Makefile文件,使用make命令,编译生成.ko文件。
7. 格式化磁盘
使用ext4文件系统格式化设备myramdisk,格式化的过程中可以看到打印出的每一次request处理的信息。
8. 挂载设备
最后使用mount命令将设备挂载到/mnt目录下,就可以像其他设备一样进行数据的读写操作。 为什么一个设备已经被系统识别在/dev下,为什么不能直接访问,而需要继续mount。 原因在于,设备文件只能读取设备自身的一些基本信息。 如果读取内部数据的话,由于块设备支持文件系统,很多设备的文件系统并不一样没法直接读取。 必须得按照一定的格式去解析设备里的文件。而mount就按照你指定的格式去读取设备里的数据。
原文链接:http://kerneltravel.net/blog/2020/io_sys_szp_no5/
存储
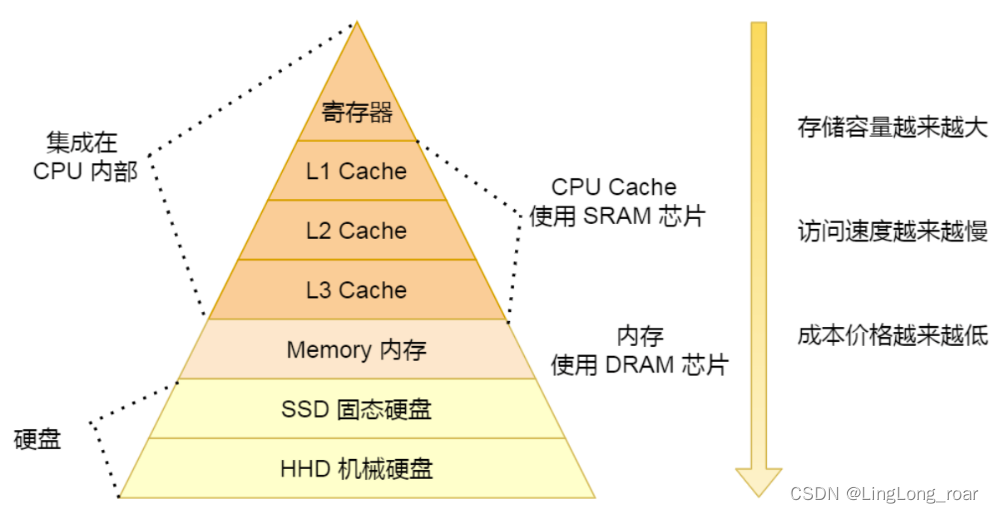
1、ROM(Read Only Memory,只读存储器)和RAM(Random Access Memory,随机存取存储器)指的都是半导体存储器,ROM在系统停止供电的时候仍然可以保持数据,而RAM通常都是在掉电之后就丢失数据。
2、RAM分为两大类:SRAM和DRAM。
SRAM为静态RAM(Static RAM/SRAM),SRAM速度非常快,是目前读写最快的存储设备,但是它也非常昂贵,所以只在要求很苛刻的地方使用,譬如CPU的一级缓冲,二级缓冲。
DRAM为动态RAM(Dynamic RAM/DRAM),DRAM保留数据的时间很短,速度也比SRAM慢,不过它还是比任何的ROM都要快,但从价格上来说DRAM相比SRAM要便宜很多,计算机内存就是DRAM的。RAM价格相比ROM和FLASH要高。
3、FLASH存储器又称闪存,它结合了ROM和RAM的长处,不仅具备电子可擦除可编程(EEPROM)的性能,还不会断电丢失数据同时可以快速读取数据(NVRAM的优势),U盘和MP3里用的就是这种存储器。
问题:目前手机用的是哪种DDR?
目前手机主要使用的是 LPDDR4(Low Power DDR4) 和 LPDDR3(Low Power DDR3)两种类型的内存,它们都是基于 DDR4 和 DDR3 标准设计的低功耗型内存,能够为手机等移动设备提供更高的带宽和更低的能耗。
相对于 LPDDR3,LPDDR4 内存的主要区别在于以下几个方面:
- 更高的带宽:LPDDR4 内存采用了更高频率的时钟,从而实现了更高的数据传输速率,其理论峰值带宽达到了 4266 MB/s。这比 LPDDR3 内存的峰值带宽提高了很多。
- 更低的功耗:LPDDR4 内存采用了更加先进的制程技术,能够在低电压下运行,从而降低了功耗。此外,LPDDR4 内存还支持更多的低功耗模式,能够在手机等移动设备的待机等场景下,进一步降低功耗,延长续航时间。
- 更强的稳定性:LPDDR4 内存采用了更加严格的校验和纠错机制,能够检测和修复更多的内存错误,从而提高系统稳定性和可靠性。
- 更大的容量支持:LPDDR4 内存能够支持更大的内存容量,最高可达到 16GB,这意味着手机等移动设备能够运行更加复杂和庞大的应用程序。
总之,相较于 LPDDR3,LPDDR4 内存在带宽、功耗、稳定性和容量支持等方面都有了明显的提升,能够为手机等移动设备提供更好的性能和用户体验。
1. 内存映射
由于所有用户进程总的虚拟地址空间比可用的物理内存大很多,但实际上大多数程序只占用实际可用内存的一小部分,因此只需要将最常用的部分与物理页帧关联。在将磁盘上的数据映射到进程的虚拟地址空间的时,内核必须提供一个数据结构,以建立虚拟地址空间和实际物理地址空间的相关数据所在位置之间的关联,linux软件系统多级页表映射机制由此诞生。
注:上图中的最右侧page,代表软件层面的页帧率,并非真正的物理内存。真正的物理内存也会分页,名称为页框,页帧到页框的转换则是由MMU自动完成的。以下讨论均不考虑MMU(MMU完成的工作作为黑箱看待)
Linux的页表实现
问题:页表的存放在哪?
页表存放在物理内存中
问题:每个页表项存储了哪些内容?
每个页表项存储了一个虚拟页号与物理页号之间的映射关系,通常包含以下信息:
- 有效位(Valid Bit):用于标识该页表项是否有效。如果该位为0,则表示该页表项无效,对应的虚拟页并未在物理内存中分配;如果该位为1,则表示该页表项有效,对应的虚拟页已经在物理内存中分配。
- 物理页号(Physical Page Number):用于记录该虚拟页所对应的物理页的页号。物理页是指实际分配给进程的物理内存页面,它的大小通常为4KB或2MB。
- 访问权限(Access Control):用来指定进程对该物理页的访问权限,包括读、写、执行等操作。这些权限是由操作系统在创建一级页表时进行设置的,以保证进程的数据和代码的安全性。
- 脏位(Dirty Bit):用于记录该物理页是否被修改过。如果该位为1,则表示该页被修改过;如果该位为0,则表示该页未被修改过。脏位通常用于虚拟内存管理,当物理页面需要被替换出去时,操作系统可以根据脏位的值来决定是否需要将其写回到磁盘上。
- 保留位(Reserved Bit):用于未来扩展。
总之,页表项是一种用于管理虚拟地址和物理地址之间映射关系的数据结构,每个页表项中存储了虚拟页号和物理页号之间的对应关系,以及其他一些与页面访问、管理相关的控制信息。
问题:映射方式有哪些?
直接映射,全相联映射,组相联映射。原文链接:https://blog.csdn.net/qq_36334929/article/details/108587172
1. 一级页表
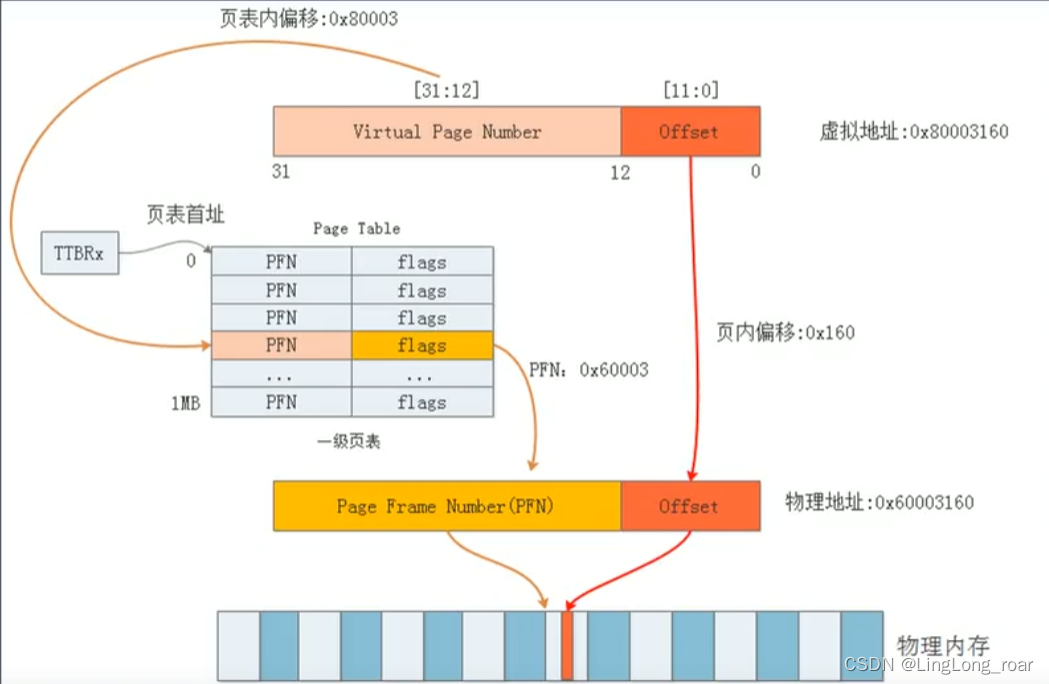
一个32位逻辑地址空间的计算机系统,一个进程分配的虚拟地址空间总大小为4G字节,一个物理页大小为4KB,一级页表的本质就是一个物理页用一个虚拟页做映射,则有4G/4K = 1M个页,那么需要存放1M个条目(一个页需要对应一个条目)。假设每个条目占4B(32位线性地址),则需要4M字节内存来存放页表。
每个进程都需要管理所有4G内存,所以每个进程都要4M来存放页表,极其浪费。
问题1:为什么一级页表在程序开始时要创建所有的页表?
如果分配的页表项不足,那么进程的部分虚拟地址空间就无法映射到物理地址空间上,进程将无法正常运行。所以,在使用一级页表时,需要提前创建好所有的页表项,以确保进程能够正确地使用其完整的虚拟地址空间。
2. 二级页表

虚拟地址到物理页地址的转换过程如下:
- 结合在CR3寄存器中存放的页目录(Page Directory Entry, PDE)的这一页的物理地址,再加上从虚拟地址中抽出高12位叫做页目录表项(内核也称这为PDE)的部分作为偏移, 即定位到可以描述该地址的PDE;
- 从该PDE中可以获取可以描述该地址的页表的物理地址,再加上从虚拟地址中抽取中间8位作为偏移, 即定位到可以描述该地址的PTE;
- 在这个PTE中即可获取该地址对应的页的物理地址, 加上从虚拟地址中抽取的最后12位,即形成该页的页内偏移, 即可最终完成从虚拟地址到物理地址的转换。
其中 虚拟地址的组成:
DIRECTORY [20:31] 可表示4096个页目录(PDE)
TABLE[12:19] 可表示256个页表(PTE)
OFFSET[11:0] 可表示4096个物理内存
因此最大映射物理内存大小为 4096*256*4096 = 4G Byte
二级页表所占用的物理内存:
一级页表PDE: 一共4096项,一个entry 4字节,共4096*4 = 16KB
二级页表PTE: 一共4096个PTE页表,一个PTE页表包含256个页表项Entry,一个entry 4字节,共4096*256*4 = 4MB
所以一共是4MB + 16KB。
但是由于如上所说,一个进程不会映射所有的地址空间,所以二级页表PTE不会全部进行创建,所以实际上不会占用这么多物理内存,但是一级页表的所有页表都需要进行创建。
二级页表的优势:
- 不需要大量连续的物理内存(从PDE寻址到PTE是起始地址+偏移实现的,所以PDE的地址必须是连续的)
- 一个进程不会映射所有的虚拟地址空间,也就不会创建所有的PTE页表。
- 随着页表级数增加,可以节省物理内存。
3. 三级页表
当X86引入物理地址扩展(Pisycal Addrress Extension, PAE)后,可以支持大于4G的物理内存(36位),但虚拟地址依然是32位,原先的页表项不适用,它实际多4 bytes被扩充到8 bytes,这意味着,每一页现在能存放的pte数目从1024变成512了(4k/8)。相应地,页表层级发生了变化,Linus新增加了一个层级,叫做页中间目录(page middle directory, PMD)
办法是针对使用2级页表的架构,把PMD抽象掉,即虚设一个PMD表项。这样在page table walk过程中,PGD本直接指向PTE的,现在不了,指向一个虚拟的PMD,然后再由PMD指向PTE。这种抽象保持了代码结构的统一。
该方法其实就是在原有虚拟地址组成中的几位作为PMD索引:
|31| -----PGD-----|29|-----PMD-----| 20|-----PTE-----|11|----OFFSET|-----|0|
4. 四级页表
硬件在发展,3级页表很快又捉襟见肘了,原因是64位CPU出现了, 比如X86_64, 它的硬件是实实在在支持4级页表的。它支持48位的虚拟地址空间(不过Linux内核最开始只使用47位)。如下:
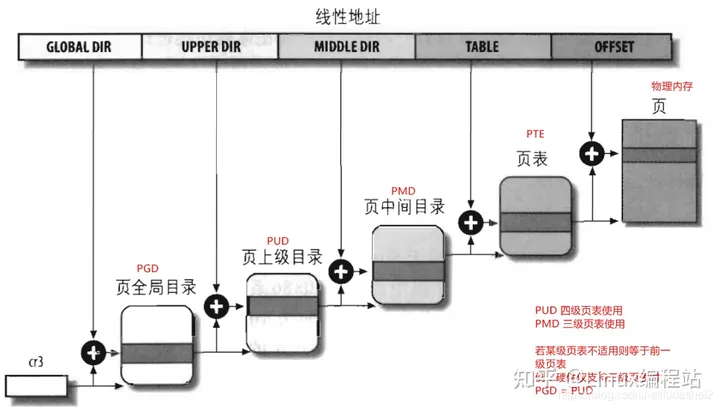
需注意软件的页表映射依赖于硬件所支持的映射级别,目前ARM64支持2/3/4 级映射,假如ARM配置的映射级别为3级,那么linux的映射表中 PGD=PUD,即实际为三级映射。
原文链接:
https://www.cnblogs.com/LyShark/p/15781225.html
2.cache
2.1 一二三级缓存(L1\L2\L3)
- L1、L2、L3都是SRAM,即Static RAM,静态RAM,速度很快
- L1、L2、L3速度依次递减,容量依次递增,价格依次递减
- L1、L2、L3都是集成在CPU内部
- 我们常用的内存是DRAM,即dynamic RAM,动态RAM,速度较慢
【问题】为什么需要缓存?
因为CPU执行一条指令只需要1ns,而从内存中获取数据需要100ns,这显然拉低了CPU的处理速度,所以提前CPU提前把可能需要用到的数据放入缓存中,需要查找数据的时候先从缓存中查找,查找不到再从内存中查找。
Cache中存放的是地址和物理地址中的数据(虚拟地址到物理地址的映射表+物理地址中的数据或者物理地址+物理地址中的数据,即虚拟缓存或物理缓存,下文会讲),用来弥补CPU和内存之间的速度鸿沟。而CPU查找数据都是通过虚拟地址进行查找,所以缓存中存放的是虚拟地址到物理地址的映射表和物理地址中的数据。
Cache存储数据是固定大小为单位的,称为一个Cache entry,这个单位称为Cache line或Cache block。给定Cache容量大小和Cache line size的情况下,它能存储的条目个数(number of cache entries)就是固定的。因为Cache是固定大小的,所以它从DRAM获取数据也是固定大小。对于X86来讲,它的Cache line大小与DDR3、4一次访存能得到的数据大小是一致的,即64Bytes。对于ARM来讲,较旧的架构(新的不知道有没有改)的Cache line是32Bytes,但一次内存访存只访问一半的数据也不太合适,所以它经常是一次填两个Cache line,叫做double fill。
每个 Cache line 存储了从主存中传输过来的若干连续字节的数据块,通常的大小为 64 字节,这是因为 CPU 处理器在读取内存时通常会一次性读取 64 字节的数据,将这些数据缓存到 Cache 中,以提高访问效率。
在一个 64 字节的 Cache line 中,包含了以下几个部分:
- 标记(Tag):用于存储该 Cache line 对应的主存地址的高位,通常是由主存地址的高几位进行组合得到的一个标识符。当 CPU 需要访问某个主存地址时,会将该地址的高位与 Cache 内已存在的所有标记进行比较,以判断该地址是否已经被缓存到了 Cache 中。
- 数据(Data):用于存储主存中该 Cache line 对应的数据块,在访问内存时,如果该数据块已经被缓存到 Cache 中,CPU 可以直接从 Cache 中读取数据,而不必再次访问主存,这样可以大大提高访问速度。
- 状态位(Valid Bit & Dirty Bit):用于记录当前 Cache line 的状态信息。其中 Valid Bit 表示该 Cache line 是否有效,Dirty Bit 表示该 Cache line 的数据是否已经被修改过。当 CPU 对 Cache line 进行写操作时,Dirty Bit 会被设置为 1,表示该缓存行中的数据已经被修改过,需要在某个时刻将其写回到主存中。
CPU从Cache拿数据的最小单位是1Byte,Cache从Memory拿数据的最小单位是64Byte,Memory从硬盘拿数据通常最小是4092Byte。
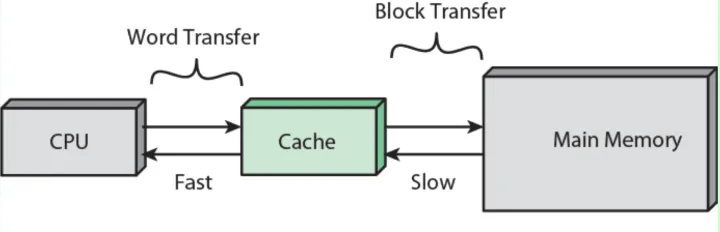
L1缓存通常也分为两种方式,分为指令缓存和数据缓存。指令高速缓存处理有关CPU必须执行的操作的信息,而数据高速缓存则保留要在其上执行操作的数据。
在大多数现代CPU中,L1和L2高速缓存位于CPU内核本身,每个内核都有自己的高速缓存。而L3高速缓存放在CPU裸片上,所有内核共享,并且占用了很大一部分空间。

2.2 TLB(Translation Lookaside Buffer,转译后备缓冲器)
由于CPU首先接到的是由程序传来的虚拟内存地址,所以CPU必须先到物理内存中取页表,然后对应程序传来的虚拟页面号,在表里找到对应的物理页面号,最后才能访问实际的物理内存地址,也就是说整个过程中CPU必须访问两次物理内存(实际上访问的次数更多)。因此,为了减少CPU访问物理内存的次数,引入TLB。
TLB是一种高速缓存,用于加速虚拟地址到物理地址的转换过程。在处理器访问内存时,如果需要进行虚拟地址(输入)到物理地址(输出)的转换,则首先会在 TLB 中查找对应的项,以快速确认物理地址。TLB 中主要存储了以下内容:
- 虚拟页号(VPN):指用于识别虚拟地址所属的虚拟页的位字段。TLB 中会记录多个虚拟页号,以便快速找到与之对应的物理页。
- 物理页号(PPN):指虚拟页号最终转换为的物理页号,表示该虚拟页所映射到的物理地址的起始位置。处理器访问内存时,会将虚拟页号替换为对应的物理页号。
- 访问权限位:指用于描述虚拟地址的访问权限的标志位,例如读、写、执行等。
- 超级用户标志位:指用于标识当前内存访问是否属于超级用户特权级别的标志位。
- TTL(Time-to-Live)计数器:指用于记录 TLB 缓存项的存活时间的计数器。当计数器减为零时,表示对应的 TLB 缓存项已过期,需要重新加载。
总之,TLB 中主要存储了虚拟地址到物理地址的映射信息,以及与之相关的访问权限和超级用户标志位。通过提供高速的地址转换服务,TLB 可以显著提高内存访问效率,加速计算机的运行速度。
虚拟地址转换物理地址的过程
打开mmu后,cpu访问的都是虚拟地址,当cpu访问一个虚拟地址的时候,会通过cpu内部的mmu来查询物理地址,mmu首先在TLB中根据虚拟地址查找物理地址,如果找到相应表项,直接获得物理地址;如果在TLB没有找到,就会通过虚拟地址从页表基地址寄存器保存的页表基地址开始查询多级页表,最终查询到找到相应表项,会将表项缓存到TLB中,然后从表项中获得物理地址,获得物理地址中的数据后,一方面拿走使用,另一方面会放入缓存中,以便再次使用。

TLB可介于CPU和CPU缓存之间,或在 CPU缓存和主存之间,这取决于缓存使用的是物理寻址或是虚拟寻址。如果缓存是虚拟定址,定址请求将会直接从 CPU 发送给缓存,然后从缓存访问所需的 TLB 条目。如果缓存使用物理定址,CPU 会先对每一个存储器操作进行 TLB 查寻,并且将获取的物理地址发送给缓存。两种方法各有优缺点。
物理高速缓存
什么是物理高速缓存?得到物理地址后,使用物理地址查询高速缓存。缺点是CPU只有在查询TLB和MMU后才能访问cache,流水线时间延迟时间相对来说增加了。
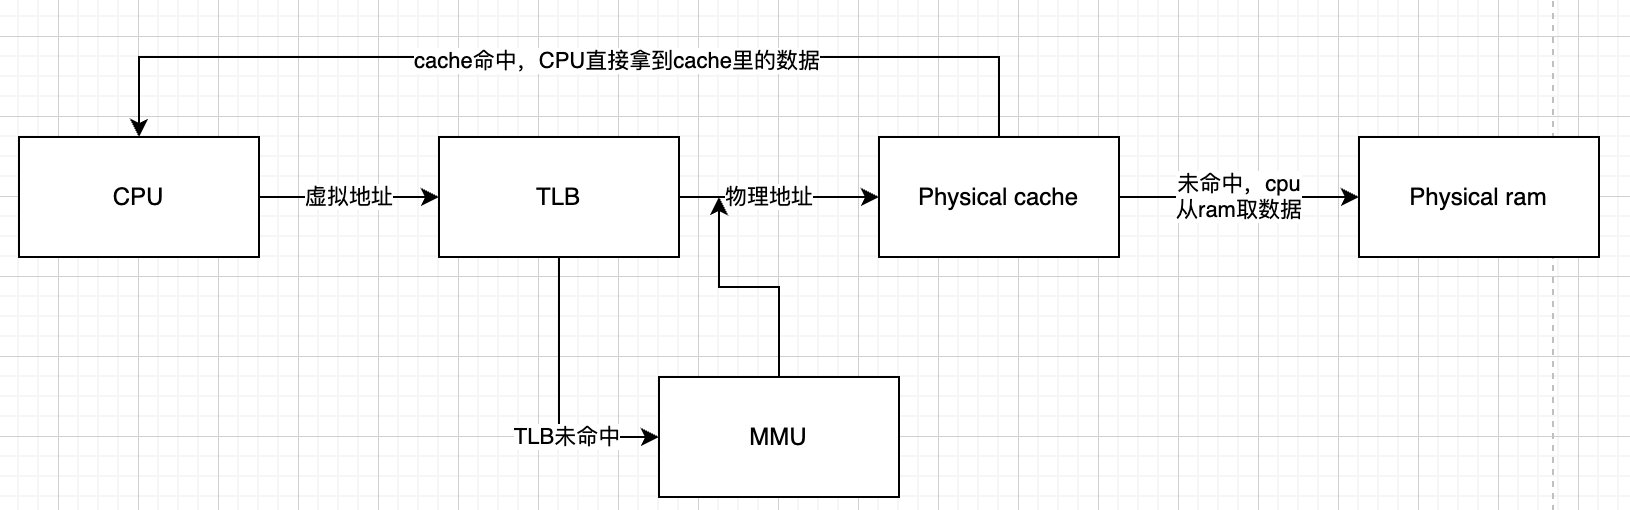
缺点:使用物理高速缓存的缺点就是处理器在查询MMU和TLB后才能访问高速缓存,增加了流水线的延迟时间。
虚拟高速缓存
什么是虚拟高速缓存?使用虚拟地址进行寻址cache,无需访问TLB和MMU。
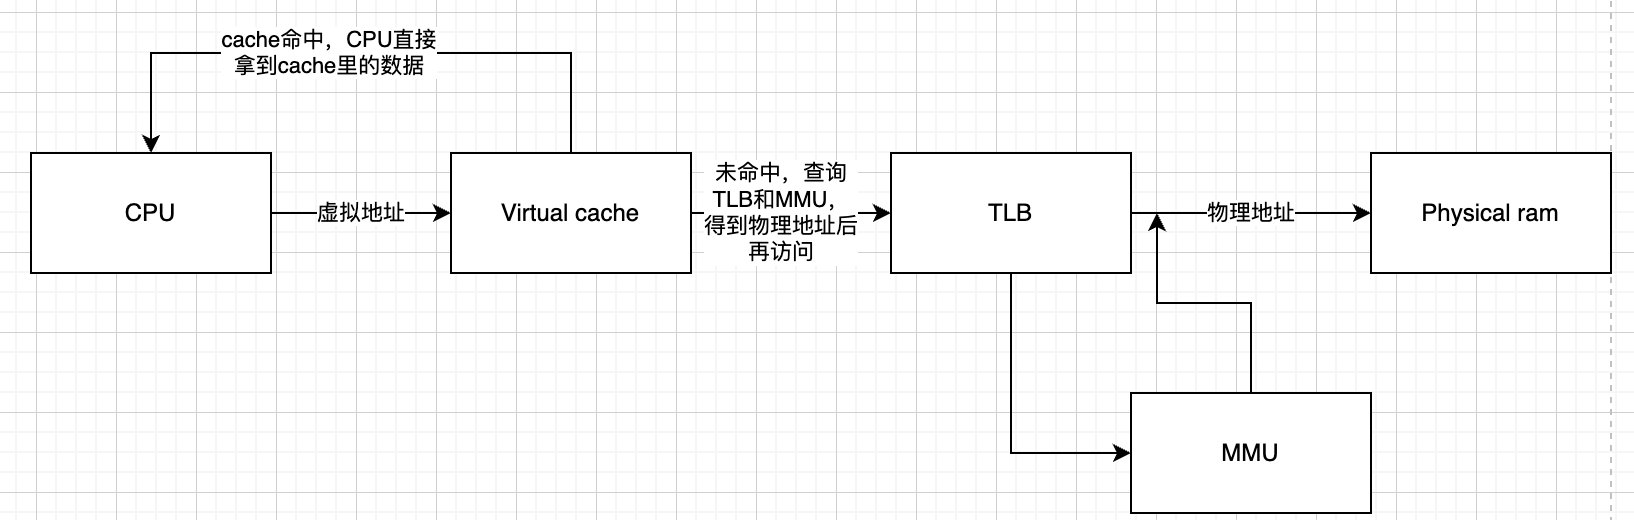
缺点:会引入问题:1.重名(aliasing)问题,2.同名(homonyms)问题
在虚拟高速缓存中,重名问题(aliasing)和同名问题(homonyms)是两种关键的缓存一致性挑战,源于虚拟地址到物理地址映射的非唯一性。
重名问题指多个不同的虚拟地址映射到相同的物理地址,导致同一物理数据在缓存中可能被存储为多个副本,从而引发缓存空间浪费和写入不一致。
例如,在VIVT(虚拟索引虚拟标记)结构中,当一个虚拟地址对应的缓存行被修改时,其他映射到同一物理地址的虚拟地址缓存副本可能保留旧值,需通过硬件机制(如清空或更新所有相关缓存行)或软件干预(如页面着色)解决。
同名问题指同一个虚拟地址可能映射到不同的物理地址,通常发生在进程切换时,一个虚拟地址在不同地址空间下对应不同物理位置,导致缓存访问错误。
例如,在虚拟高速缓存中,进程A和进程B都使用虚拟地址0x50000,但进程A映射到物理地址0x400,进程B映射到物理地址0x800;若缓存未及时失效,进程B的访问可能命中进程A的缓存行,返回错误数据,解决方法包括在进程切换时使整个缓存无效,或使用地址空间标识符(如ASID)区分不同进程的缓存条目。
不同缓存结构对这些问题的处理方式各异:
- VIVT:完全使用虚拟地址索引和标记,易受重名和同名问题影响,需额外机制保证一致性。
- VIPT:使用虚拟地址索引和物理地址标记,可缓解重名问题(当缓存容量不超过页面大小时),但无法完全避免同名问题。
- PIPT:完全基于物理地址,从根本上避免两类问题,但需每次访问前转换地址,增加延迟。
原文链接:https://blog.csdn.net/dai_xiangjun/article/details/120178369
原文链接:https://blog.csdn.net/m0_56561130/article/details/118405261
3. GDT和LDT
GDT和LDT是操作系统中内存管理的两个重要概念,它们都用来描述内存中段的属性和限制。下面分别介绍一下 GDT 和 LDT 的含义和作用:
GDT(全局描述符表)是一个存储在内存中的数据结构,用于描述整个系统范围内的段属性和访问权限。在操作系统启动期间,操作系统会将 GDT 加载到 CPU 的 GDTR 寄存器以便 CPU 访问。GDT 中包含了一组段描述符(Segment Descriptor),用于描述各个段的基地址、大小、属性等信息。通过这些描述符,操作系统可以对不同程序访问内存的行为进行限制,同时还可以实现内存保护和隔离等功能。
GDT是一个系统级别的数据结构,存储着系统中所有段的基本信息,包括:
- 段描述符(Segment Descriptor):每个段描述符包含了该段的基地址、大小、访问权限、段类型等信息,用于描述各个段的属性和限制。
- 选择子(Selector):选择子是用来唯一标识一个段的,每个选择子由一个16位的段选择符和一个指向GDT中对应段描述符的偏移量构成。
- GDTR寄存器:GDTR寄存器是一个48位的寄存器,存储GDT的起始地址和限长信息,通过它可以让CPU访问GDT。
LDT(局部描述符表)是一种用户级别的描述符表,用于描述当前进程的数据和代码段的属性和限制。LDT 类似于 GDT,但是只用于描述当前进程所拥有的段。在进程切换时,操作系统会将新进程的 LDT 加载到 CPU 的 LDTR 寄存器以便 CPU 访问。每个进程都有自己的 LDT,这样可以避免不同进程之间相互干扰或者破坏对方代码或数据段的情况出现。
LDT是一个进程级别的数据结构,存储着当前进程所拥有的段的信息,包括:
- 段描述符(Segment Descriptor):与GDT中的段描述符类似,每个LDT中的段描述符也包含了该段的基地址、大小、访问权限、段类型等信息,用于描述进程中各个段的属性和限制。
- LDT寄存器(LDTR):LDTR寄存器是一个16位的寄存器,存储当前进程的LDT在GDT中的选择子,通过它可以让CPU访问LDT。
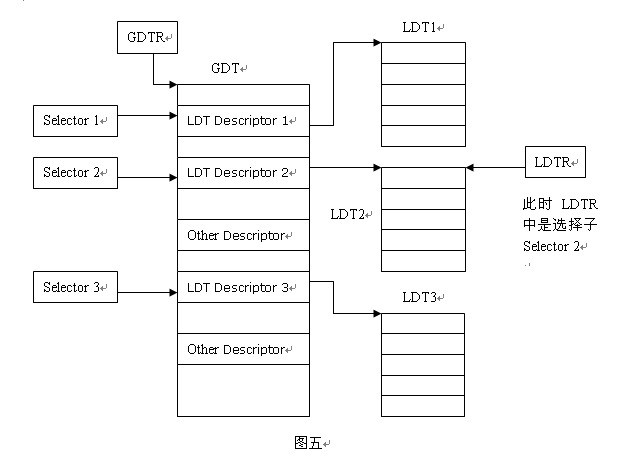
总之,GDT和LDT都是用于描述内存中段的属性和限制,并且都是通过描述符来实现的。GDT描述全局段信息,而LDT描述局部(进程)段信息。通过使用 GDT 和 LDT,操作系统可以更加灵活地管理内存资源,从而提高安全性和可靠性。
参考链接:https://blog.csdn.net/qq_42762094/article/details/120423812
DMA buffer
DMA(Direct Memory Access,直接内存访问)是一种计算机系统中的数据传输方式,它可以在不占用CPU的情况下,直接将数据从外设传输到内存或从内存传输到外设。
DMA buffer的核心作用是解决多设备驱动间内存共享问题,通过允许硬件外设直接访问内存,避免不必要的数据复制,从而降低延迟和CPU负载,常见于多媒体处理、图形渲染等场景。
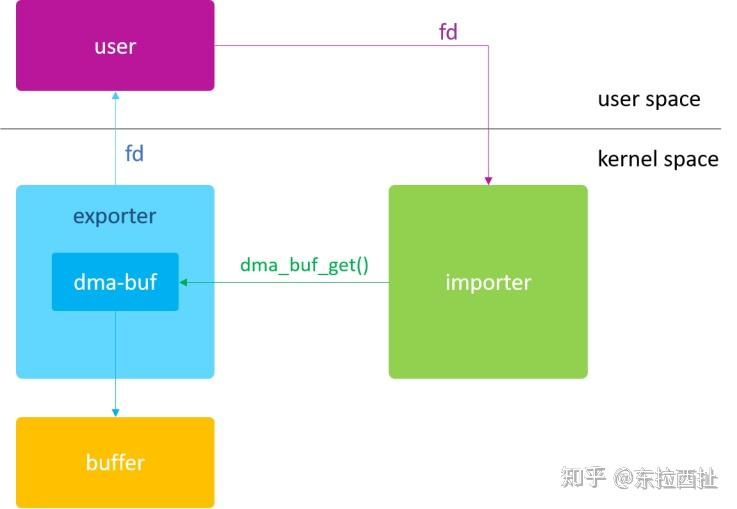
DMA buffer的组成部分主要包括DMA-BUF框架、exporter、importer、文件描述符(fd)和同步机制:
- DMA-BUF框架:作为底层共享机制,将buffer与文件抽象结合,每个buffer对应唯一inode,通过文件接口实现跨驱动流转。
- exporter:负责分配和管理buffer的驱动模块,提供内存后端并实现回调函数(如map/unmap)。
- importer:使用共享buffer的驱动或应用,通过文件描述符关联到exporter的buffer,无需关心其具体来源。
- 文件描述符(fd):作为buffer的引用媒介,在进程间传递时实现共享。
- 同步机制:包括fence等,用于协调异步硬件访问,确保数据一致性。
工作原理基于文件抽象实现跨驱动共享:
- exporter通过DMA-BUF框架分配buffer并生成fd;
- importer获取fd并通过dma_buf_get()转换为DMA-BUF对象;
- importer调用dma_buf_attach()将buffer附加到本地设备,获取scatterlist以映射内存;
- importer通过map/unmap接口进行DMA访问,期间框架自动处理cache一致性(如cpu_access)。
- 其中同步通过fence机制实现,例如在数据处理完成后触发信号通知其他设备。
需要注意的是,DMA传输过程中不需要CPU参与,因此可以大大提高数据传输的效率。同时,DMA传输也有一定的局限性,比如只能进行简单的数据传输,不能进行复杂的数据处理等。
DMA技术的应用广泛,比如在视频处理、音频处理、网络传输、磁盘存储等领域都有着重要的作用。但同时,由于DMA可以直接访问内存,如果没有进行有效的安全和隔离措施,可能会导致数据泄露或篡改等问题。因此,在使用DMA技术时,必须采取相应的安全措施来保护系统安全。
具体来说,高通框架中通过硬件DMA引擎来管理主机与设备之间的数据传输。在传输数据时,CPU会将数据缓存在指定的内存区域中,然后通过DMA引擎控制器将数据直接从内存传输到设备,或者从设备读取数据并直接写入内存,避免了CPU参与的繁琐工作,提高了系统效率和响应速度。
高通框架中的DMA引擎支持多个DMA通道,每个通道可以控制一个特定的设备进行数据传输,同时还提供了高速缓存、DMA链表和中断处理等功能,以满足不同场景下的数据传输需求。同时,在安全性方面,高通框架中还采用了诸如内存保护、IOMMU内存映射、DMA流控等技术来保障系统的安全性和可靠性。
DMA分配的内存在物理地址上是连续的吗?
DMA 分配的内存地址是否连续,取决于具体的实现方式。
在一些简单的实现中,DMA 分配的内存可以是连续的物理内存空间,也就是说,DMA 可以像普通 CPU 写入内存一样,线性顺序地写入数据到分配的这段连续物理内存中。
但是,在一些更复杂的或者安全性要求更高的实现中,DMA 分配的内存并不一定连续。例如,为了保障安全性,系统可能会在 DMA 操作时使用内存映射 I/O(MMIO)技术,在主机物理内存和设备 I/O 端口之间建立虚拟地址映射,将 DMA 访问的内存区域映射到不同的物理内存页上,从而提高安全性,并且防止恶意设备访问非法内存区域。
总之,DMA 分配的内存是否连续,取决于具体的实现方法、系统架构和安全策略。
在使用DMA技术时,一般采取哪些安全措施来保护系统安全?
DMA 可能被恶意软件利用进行非法读写内存,或者窃取机密信息等。
为了保护系统安全,可以采取以下一些技术:
- IOMMU(Input-Output Memory Management Unit,输入输出内存管理单元)技术:IOMMU 可以将设备访问地址映射到虚拟地址空间,从而防止 DMA 访问到非法物理地址。通过 IOMMU,可以控制 DMA 操作所涉及的物理地址范围,保护系统中关键数据和代码区域。
- 内存隔离:将不同设备所使用的内存区域进行隔离,防止 DMA 访问到意外的内存区域,避免对操作系统和应用程序造成影响。例如,可以为每个设备分配专门的内存区域,限制它们对其他设备所使用的内存区域的访问。
- 内存加密:对系统内存进行加密,防止 DMA 等攻击手段获取敏感数据。可采用硬件实现或软件实现的加密方式,将敏感数据在内存中加密存储,只有在需要使用时才进行解密操作。
- 及时更新系统补丁:及时更新操作系统和硬件设备的驱动程序以及固件,修补已知的漏洞。
- 启用审计和监控:对系统进行定期审计和监控,检查是否存在异常的 DMA 访问活动。同时,在系统中安装防火墙和入侵检测等安全工具,增强系统的安全性能,保护系统免受恶意攻击。
以上是一些常用的技术来保护系统安全,针对不同场景可以采取不同的措施。
DMA buffer的分配是不是只能在驱动层分配,不能在用户空间分配?
DMA buffer可以在用户空间分配,而且这正是现代Linux系统的趋势。
实际上,DMA缓冲区的分配可以在驱动层进行,也可以在用户空间进行,但这取决于具体的系统和内核支持。下面我将详细解释:
-
传统方式:驱动层分配
在早期或一些简单的系统中,DMA缓冲区通常由设备驱动在内核空间分配。这种方式下,驱动使用内核提供的DMA分配接口(如dma_alloc_coherent、dma_map_single等)来分配物理上连续的内存(或者使用分散/聚集列表)。然后,驱动可以将这个缓冲区的地址提供给设备进行DMA操作。如果用户空间需要访问这个缓冲区,则需要通过mmap系统调用将内核缓冲区映射到用户空间。 -
用户空间分配:DMA-buf Heaps
随着Linux内核的发展,现在用户空间也可以直接分配DMA缓冲区。这是通过DMA-buf Heaps机制实现的。DMA-buf Heaps是一个框架,它允许用户空间通过一个统一的接口分配不同类型的DMA缓冲区。例如,从Linux 5.0开始,内核提供了多个DMA-buf Heaps,如:
用户空间可以通过打开对应的设备文件(如
/dev/dma_heap/system)并调用ioctl来分配DMA缓冲区。分配成功后,会返回一个文件描述符(fd),这个fd代表了一个DMA缓冲区对象(DMA-buf)。然后,用户空间可以使用这个fd进行mmap映射,或者将它传递给其他设备或进程。-
system:分配物理上连续的内存(通常用于小缓冲区) -
cma:从CMA(连续内存分配器)区域分配,适合大块连续内存 -
其他特定硬件的堆
-
-
用户空间分配步骤示例(使用DMA-buf Heaps):
// 打开堆设备 int heap_fd = open("/dev/dma_heap/system", O_RDWR); // 设置分配参数 struct dma_heap_allocation_data alloc_data = { .len = size, .fd_flags = O_CLOEXEC | O_RDWR, }; // 分配缓冲区 ioctl(heap_fd, DMA_HEAP_IOCTL_ALLOC, &alloc_data); // 获取DMA-buf的fd int dmabuf_fd = alloc_data.fd; // 映射到用户空间 void *ptr = mmap(NULL, size, PROT_READ | PROT_WRITE, MAP_SHARED, dmabuf_fd, 0); // 现在可以使用ptr访问缓冲区 -
混合分配方式
在实际应用中,也可以采用混合方式:由用户空间分配DMA缓冲区,然后将fd传递给驱动,驱动将这个缓冲区映射到设备地址空间(通过DMA-buf的attach/map操作),并告诉设备使用这个缓冲区进行DMA操作。 -
注意事项
-
用户空间分配的DMA缓冲区通常需要物理上连续,或者至少是设备DMA可以访问的(通过IOMMU)。这取决于硬件和配置。
-
缓存一致性问题:在用户空间直接访问DMA缓冲区时,需要注意缓存一致性。通常,DMA-buf提供了同步操作(通过DMA_BUF_SYNC_START和DMA_BUF_SYNC_END)来确保CPU和设备看到的数据一致。
-
不是所有的硬件平台都支持用户空间分配DMA缓冲区,需要内核配置了相应的DMA-buf Heaps驱动。
-
总结:DMA缓冲区的分配既可以在驱动层进行,也可以在用户空间进行(通过DMA-buf Heaps)。用户空间分配的方式提供了更大的灵活性,使得用户空间程序可以方便地共享缓冲区。
原文链接:https://zhuanlan.zhihu.com/p/468033445
https://blog.csdn.net/u011795345/article/details/129306630
DMA 有哪几种工作模式?
一、先总览
DMA 最核心三种模式:
- 普通模式(Normal 单次模式)
- 循环模式(Circular / Loop 循环缓冲)
- 乒乓 DMA(Ping-Pong 双缓冲 DMA)
相机、MIPI、Sensor、SPI 大数据传输基本都靠后两种。
1. 普通模式(单次模式)
原理
- 配置一次 源地址、目的地址、长度
- DMA 跑完一次传输就停止,不再自动重来
- 想再传,必须CPU 重新配置
特点
- 简单
- 不适合连续流式数据
- 每次传完都要软件重新初始化
使用场景
零散短数据:SPI 单次寄存器读写、少量配置命令、非连续小数据。
一句话总结
跑一次就停,需 CPU 重新配置才能再跑。
2. 循环模式(Circular DMA)
原理
- 配置一个环形缓冲区
- DMA 传输到末尾后,硬件自动跳回缓冲区开头,无限循环
- 不需要 CPU 重新配地址,硬件自动循环
特点
- 适合不间断流式数据
- 自动环回,软件只需要处理半满 / 满中断
- 缓冲区固定一块内存循环复用
相机典型场景
- 持续 MIPI 原始数据流
- 持续麦克风音频流
- 持续串口高速数据流
一句话总结
一块缓冲区,硬件自动循环从头再来,适合长时间不间断数据流。
3. 乒乓 DMA(Ping-Pong 双缓冲 DMA)【重点】
原理核心
准备两块独立缓冲区:BufA、BufB
- 先配置 DMA 往 BufA 传数据
- 当 BufA 传满:
- DMA 自动切换到 BufB 继续收数据
- CPU 同时处理已经满的 BufA
- 当 BufB 传满:
- DMA 切回 BufA
- CPU 处理 BufB
一边硬件收数据,一边 CPU 处理数据,并行工作,像乒乓球来回切换,所以叫乒乓 DMA。
特点
- 双缓冲交替,无数据断层、不丢帧
- 接收和业务处理完全并行
- 适合高速连续大数据流
相机 / 嵌入式最常用场景
- MIPI CSI 图像帧采集(最典型)
- SPI 高速大屏刷屏
- 高速 ADC 连续采样
- 音频实时流
- RAW/YUV 帧持续接收
一句话总结
两块缓冲区轮流干活,DMA 收一块、CPU 处理另一块,无缝衔接、不丢帧、不停流。
二、三种模式对比(面试直接说)
表格
| 模式 | 是否自动重复 | 缓冲区数量 | 适合场景 |
|---|---|---|---|
| 普通模式 | 否,一次就停 | 单块 | 短报文、单次传输 |
| 循环模式 | 硬件自动循环 | 单块环形缓冲 | 持续流式、中等速率 |
| 乒乓 DMA | 自动交替切换 | 两块独立缓冲 | 高速连续大数据、相机帧采集 |
三、面试标准口述版(直接背)
DMA 有三种常见工作模式:
第一种是普通单次模式,配置一次只传输一次就停止,需要软件重新配置,适合零散短数据传输。
第二种是循环模式,配置一块环形缓冲区,DMA 传输到末尾硬件自动跳回开头循环传输,适合长时间不间断的流式数据,比如音频、普通传感器数据流。
第三种是乒乓 DMA 双缓冲模式,也是相机驱动里用得最多的。准备两块缓冲区,DMA 先往第一块传输,满了自动切到第二块;同时 CPU 可以处理已经满的第一块,两边并行工作,无缝切换不丢帧,非常适合 MIPI 相机图像采集、SPI 高速大屏这种连续高速大数据场景。
乒乓DMA的工作原理是什么?
1. 核心原理
准备两块独立内存缓冲区:PingBuf(A 缓冲区)、PongBuf(B 缓冲区)。DMA 先往 A 灌数据,A 满了硬件自动切到 B;同时 CPU 去处理已经满的 A 缓冲区;B 满了再自动切回 A,CPU 处理 B。
硬件收数据 和 CPU 处理数据 完全并行,无停顿、不丢帧。
2. 直观示意图
初始:DMA → PingBuf(A)
数据不断灌入A

A灌满
 ├─ DMA 自动切换 → PongBuf(B) 继续收新数据
 └─ CPU 立刻处理 已满的 PingBuf(A)

B灌满
 ├─ DMA 自动切回 → PingBuf(A) 继续收新数据
 └─ CPU 立刻处理 已满的 PongBuf(B)

循环往复,永不间断
3. 关键优点
- 双缓冲无缝切换,连续数据流不中断、不丢帧
- DMA 硬件自动切换,无需 CPU 频繁重新配地址
- 接收与业务处理并行,CPU 利用率高、帧率稳
- 特别适合 MIPI 相机、高速 SPI、实时音视频
乒乓 DMA vs 循环 DMA 核心区别(面试必背)
1. 缓冲区结构不同
- 循环 DMA:单块内存做环形复用,只有一个缓冲区
- 乒乓 DMA:两块独立内存,交替轮流使用
2. 工作机制不同
- 循环 DMA:数据写到缓冲末尾,硬件自动跳回起始地址覆盖循环
- 乒乓 DMA:一块写满,硬件自动切换到另一块全新缓冲,不是原地覆盖
3. 数据完整性不同
- 循环 DMA:半区处理,容易被新数据覆盖踩踏旧数据
- 乒乓 DMA:一整块满了再交给 CPU,整块数据完整不被覆盖
4. 适用场景不同
- 循环 DMA:音频、低速串口、持续小数据流,允许半帧处理
- 乒乓 DMA:相机图像帧、高清视频、高速大数据,要求每一帧完整、不能被覆盖、不能丢帧
5. 一句话区分
循环 DMA 是一块内存转圈复用;乒乓 DMA 是两块内存交替接力,相机帧采集必须用乒乓,保证整帧完整不被覆盖。
相机驱动中 如何配置乒乓 DMA,整体配置步骤(6 步标准流程)
第 1 步:申请两块独立帧缓冲区
提前分配 PingBuf、PongBuf 两块等大、内存对齐的物理内存(相机 DMA 要求物理连续内存、地址对齐)
第 2 步:初始化 DMA 基础配置
配置:
- 外设请求源(MIPI / SPI)
- 传输方向:外设 → 内存
- 数据位宽:8bit/16bit/32bit
- 传输长度:一帧图像大小
- 优先级、字节序
第 3 步:配置 DMA 双缓冲 / 乒乓模式使能
开启 DMA 控制器的 Double Buffer / Ping-Pong 模式把两块缓冲区地址分别写入 DMA 的 主地址寄存器、备用地址寄存器
第 4 步:配置中断
使能 DMA 传输完成中断、半传输中断;中断里做:
- 标记当前哪块缓冲区已满
- 通知相机业务线程 / 3A 线程取帧处理
第 5 步:开启外设 DMA 请求 + 启动 DMA
开启 MIPI 或 SPI 外设的 DMA 发送 / 接收请求,开启 DMA 控制器,开始持续传输。
第 6 步:中断里做缓冲区状态切换
每次一块缓冲区满中断到来:
- 标记当前 Buf 就绪,抛给上层处理
- DMA 硬件已经自动切到另一块,软件只需标记状态,不用重新配地址
- 等待下一次满中断,循环往复
C 语言 极简伪代码(相机驱动风格)
// 1. 定义双缓冲
uint8_t *PingBuf = dma_alloc_coherent(FRAME_SIZE);
uint8_t *PongBuf = dma_alloc_coherent(FRAME_SIZE);

// 2. DMA 基础配置
dma_config.dir  = DMA_PERIPH_TO_MEM;
dma_config.width = DMA_WIDTH_8BIT;
dma_config.len   = FRAME_SIZE;

// 3. 配置乒乓双缓冲地址
dma_set_ping_pong_addr(DMA_CHAN, PingBuf, PongBuf);

// 4. 使能乒乓模式 + 中断
dma_enable_pingpong(DMA_CHAN);
dma_enable_irq(DMA_CHAN, DMA_IRQ_FULL);

// 5. 开启外设DMA、启动DMA
mipi_enable_dma_req();
dma_start(DMA_CHAN);

// 中断服务函数
void dma_irq_handler(void)
{
    if(irq_stat & DMA_FULL_FLAG)
    {
        if(当前是PingBuf满)
            notify_camera_frame_ready(PingBuf);
        else
            notify_camera_frame_ready(PongBuf);
        // 硬件已自动切换下一块,软件无需重配地址
    }
}
面试满分背诵版(直接背)
1. 乒乓 DMA 工作原理
乒乓 DMA 是采用两块独立缓冲区的双缓冲机制,DMA 先往第一块缓冲区传输数据,写满后硬件自动切换到第二块继续接收;同时 CPU 可以并行处理已经写满的第一块缓冲区,两块轮流切换,接收和业务处理完全并行,保证相机数据流连续、不丢帧、数据完整不被覆盖。
2. 乒乓 DMA 和循环 DMA 区别
循环 DMA 是单块内存环形覆盖复用,适合音频低速流;乒乓 DMA 是两块独立内存交替接力,每一帧数据完整独立,不会被新数据覆盖,更适合相机 MIPI 图像这种大数据、整帧完整性要求高的场景。
3. 相机驱动配置乒乓 DMA 流程
首先申请两块物理连续、地址对齐的帧缓冲区;然后配置 DMA 传输方向、位宽、帧长度,开启乒乓双缓冲模式,把两块缓冲地址配置到 DMA 主备寄存器;再配置传输完成中断,最后开启 MIPI 外设 DMA 请求和 DMA 通道。传输中硬件自动切换两块缓冲区,中断里只需要标记帧就绪、通知上层相机和 3A 线程处理即可,无需软件重复配置地址。
乒乓 DMA 的 每一块 Ping/Pong Buffer 大小是多大?
标准相机驱动做法:乒乓 DMA 的 每一块 Ping/Pong Buffer 大小 = 1 张完整 RAW 帧大小。不会把一个 Buffer 做成能存好几张 RAW,行业里几乎不这么干。
一、为什么 每个 Buffer = 单张 RAW 帧大小?
1. 相机 MIPI / ISP 天生按整帧输出
Sensor 一帧一帧发 RAW,MIPI 一帧完整收完才会给 帧结束中断。DMA 配合 MIPI 就是一帧灌完一个 Buffer,刚好匹配。
2. 乒乓机制设计初衷就是「一帧换一次缓冲」
Ping 收第 1 帧 → 满了切 Pong 收第 2 帧CPU 同时处理 Ping 里的完整第 1 帧
如果一个 Buffer 塞好几帧:
- 帧边界混乱
- 分不清第几帧从哪开始、哪结束
- 3A、ISP 处理无法按单帧调度
- 极易内存踩踏、帧错位、花屏
3. 中断逻辑天然按「单帧结束」触发
MIPI 每收完一整帧 才发 Frame End 中断,正好对应:一个 Buffer 装满一帧,交给上层处理。
4. 内存开销可控
单帧多大就配多大,不浪费;如果一个 Buffer 搞成多帧,内存占用翻倍,嵌入式 / DDR 资源浪费。
二、能不能一个 Ping Buffer 存多张 RAW?
技术上可以,但工程上没人这么做,也不推荐。
强行做成多帧 Buffer 会出现什么问题?
- 帧边界无法切割,不知道哪段是第 1 帧、哪段是第 2 帧
- 3A 统计、AE/AF/AWB 都是按单帧运算,多帧塞一起没法拆
- 一旦丢一行、错一行,后面所有帧全部错位花屏
- DMA 中断、帧同步逻辑极度复杂,维护成本极高
- 不符合手机 / 无人机相机标准框架设计范式
三、给你讲清标准架构配置(真实相机驱动标配)
假设:RAW 分辨率 1280×720,RAW10,一帧大小 = 1152000 Byte
乒乓 DMA 配置:
- PingBuf 大小 = 1152000 Byte(存 1 张 RAW)
- PongBuf 大小 = 1152000 Byte(存 1 张 RAW)
工作流程:
- DMA 往 PingBuf 灌 第 1 整帧 RAW
- 灌满 → 硬件自动切到 PongBuf 灌 第 2 整帧
- CPU 立马拿去处理 PingBuf 的 第 1 帧
- 交替往复,永远一帧一个 Buffer
四、那什么场景才会一个 Buffer 放多帧?
只有低速音视频、低速码流、非图像业务:
- 音频 PCM 流
- 串口批量日志
- 低速传感器连续采样
相机 RAW/YUV 图像采集,一律一帧一 Buffer。
五、面试标准口述背诵版
乒乓 DMA 的两块 Buffer,工程上标准配置是每一块 Buffer 大小等于一张完整 RAW 帧的大小。因为相机 Sensor 和 MIPI 是按整帧输出,DMA 配合硬件帧中断,一帧刚好填满一个缓冲区,硬件自动切换、CPU 按单帧处理,天然匹配 3A 和 ISP 按帧调度的逻辑。
虽然技术上可以把单个 Buffer 配置成存放多张 RAW 帧,但相机驱动里不会这么做,会导致帧边界无法切割、3A 统计无法按帧运算,还容易出现帧错位、内存踩踏和花屏,架构也不标准、维护复杂。
驱动中DMA 的帧buffer缓存会有4-8帧,是有多个乒乓buffer吗?
乒乓 DMA 硬件层面永远只有 2 个 Buffer(1 组乒乓);驱动里看到的 4 帧、6 帧、8 帧 大缓存队列,是「软件多帧环形缓存队列」,不是硬件多组乒乓 DMA。
不是多组乒乓,是 硬件双缓冲 + 软件多帧队列 两层架构。
一、先分清两层:硬件层 vs 软件层
1. 硬件 DMA 层
芯片控制器硬件只支持一组乒乓:固定只有 PingBuf、PongBuf 两块硬件自动切换、硬件双缓冲,最多就 2 个不能同时开 4 个、8 个硬件乒乓 Buffer,绝大多数 SOC、MCU 都不支持多组硬件乒乓同时跑图像采集。
2. 驱动软件层
在硬件 2 个 Buffer 基础上,软件再搭建一个 4/6/8 帧的环形队列缓存。
整体架构:
MIPI -> 硬件乒乓DMA(2帧)
        ↓
驱动软件环形Buffer队列(4~8帧)
        ↓
ISP/3A/应用层取帧处理
二、为什么驱动要搞 4~8 帧缓存?
既然硬件只有 2 帧,为什么软件还要扩充到 4/6/8 帧?
1. 上层处理速度跟不上硬件帧率
Sensor 源源不断出帧,ISP / 算法 / 应用线程偶尔卡顿、调度延迟。如果只有硬件 2 帧,来不及处理就会丢帧、覆盖旧帧、花屏。
软件多帧队列相当于蓄水池,临时囤住几帧,平滑调度抖动。
2. 适配多线程解耦
- 底层 DMA 中断:只管收帧、往软件队列入队
- 上层 3A、ISP、业务线程:自己节奏出队处理中间靠 4~8 帧软件队列做缓冲解耦。
3. 做帧平滑、时序对齐、防抖算法
相机 AE/AF/AWB、电子防抖、HDR 往往需要拿前几帧历史帧做运算,必须缓存多帧历史数据,所以软件开 4~8 帧环形池。
4. 防内存踩踏、做帧复用管理
软件统一管理 8 个 Buffer 的状态:空闲、就绪、处理中、等待回收避免硬件 2 帧来回切的时候被上层篡改。
三、工作流程完整拆解(一看就懂)
- 硬件层DMA 永远只有 Ping、Pong 两块,一帧一切换,硬件源源不断收 RAW。
- DMA 中断一帧收完,中断把当前满的 Ping/Pong 指针 扔进软件环形队列。
- 软件队列里面预分配好 4~8 个等大 RAW Buffer,形成循环池。
- 上层业务3A、ISP、应用层从软件队列里取帧,慢慢处理,不用追着硬件帧率跑。
四、关键结论(面试必背)
- 硬件乒乓 DMA 固定只有 2 个 Buffer,不存在 4 组、8 组硬件乒乓。
- 驱动中看到的 4~8 帧缓存,是软件层构建的环形帧缓存队列,在硬件乒乓之外额外做的缓冲池。
- 架构是:硬件双缓冲做实时无缝采帧,软件多帧队列做流量缓冲、线程解耦、历史帧留存。
- 不是多个乒乓 Buffer,是 1 组硬件乒乓 + 软件多帧环形队列。
五、面试标准口述版(直接背)
首先,DMA 硬件层面的乒乓机制永远只有两块 Buffer,芯片一般只支持一组硬件乒乓自动切换,没法同时配置 4 帧、8 帧硬件乒乓。
驱动里配置 4 到 8 帧的帧缓存,并不是多组乒乓,而是在硬件双缓冲之上,软件额外搭建了一个多帧环形缓冲队列。
硬件层负责 MIPI 实时采帧、两块乒乓 Buffer 自动切换不丢帧;软件层做 4~8 帧缓存池,用来平滑上层算法线程调度延迟、解耦底层采帧和上层 3A/ISP 处理节奏,同时留存历史帧供防抖、HDR、3A 滤波使用,避免只有硬件两帧时处理不及时导致丢帧和内存覆盖踩踏。
一张RAW图从乒乓buffer到软件多帧环形缓存队列时,是不是需要重新拷贝到环形缓冲队列中?
正常高端相机 SOC / 无人机相机驱动:不需要内存拷贝,完全零拷贝。只有低端 MCU、无内存池管理的裸驱,才会傻傻做一次内存 memcpy 拷贝。
我把原理、架构、两种做法、工业标准实现给你讲透,面试直接能讲。
一、先回答你的问题
一张 RAW 帧填满 Ping/Pong 硬件乒乓 Buffer 后:不需要把整张 RAW 再拷贝一份到软件环形队列。
而是:直接把当前已满的乒乓 Buffer 地址,挂入软件环形队列就行。只传指针,不搬数据,零拷贝。
二、标准工业架构(手机 / 无人机 / ISP 主流做法)
1. 预先一次性申请 6~8 个一模一样的 RAW Buffer
全部物理连续、同大小、对齐,统一放进 软件帧缓冲池 / 环形队列。
这些 Buffer 角色是动态轮换的:
- 某 2 块 临时充当 DMA 硬件乒乓 Ping/Pong
- 剩下几块 待命在软件队列里做空闲缓冲
2. 运行流程(零拷贝核心)
- 驱动初始化:提前建好 8 帧环形 Buffer 池,全部标记为「空闲」。
- DMA 从队列里取出两个空闲 Buffer,设为 Ping、Pong 做硬件乒乓。
- MIPI/DMA 把一帧 RAW 直接原位写入这两个 Buffer。
- 一帧收满,进 DMA 中断:
- 把这个已满 Buffer 的指针 入队到软件就绪队列
- 再从空闲队列拿一个新空闲 Buffer,替补进 DMA 乒乓
- 上层 ISP/3A / 应用直接用队列里的原地址处理,无任何内存拷贝。
极简流程示意
软件8帧环形池(空闲队列)
       ↓
取出2块 → 配置为 DMA Ping/Pong 硬件Buffer
       ↓
MIPI DMA 直接RAW写入这两块内存
       ↓
帧满中断:把这块Buffer地址送入「就绪帧队列」
       ↓
立刻再拿一块新空闲Buffer替补进DMA乒乓
       ↓
ISP/3A 直接操作原Buffer内存,不用拷贝
全程只移动指针,不搬运像素数据。
三、为什么绝不做 memcpy 拷贝?
- RAW 一帧几 MB,4K 更大,频繁拷贝极度耗 CPU、占用 DDR 带宽。
- 高帧率下拷贝来不及,必丢帧、卡顿。
- 多一次拷贝就多一次内存越界、内存踩踏风险。
- 高端相机架构设计原则:帧数据只在 DMA 写入一次,终生不二次拷贝。
四、那什么时候会真的做拷贝?(只有这种低端场景)
只有简单 MCU、无 ISP、无帧内存池、架构简陋的驱动:
- 硬件固定死只有 2 个不能动的乒乓 Buffer
- 没有软件动态缓冲池
- 只能:Ping 满 → memcpy 到外面的环形队列缓存这种才需要拷贝,正规相机 SOC 驱动绝不会这么干。
五、帮你总结最关键的底层逻辑
- 硬件乒乓 Buffer 并不是固定死的两块内存,而是从软件多帧队列里动态借出、归还的。
- 帧满后只把地址指针入队,不需要拷贝 RAW 数据,全程零拷贝。
- 处理完的帧 Buffer 放回空闲队列,循环复用,内存池化管理。
- 这么做节省 CPU、节省 DDR 带宽、避免内存拷贝带来的踩踏和耗时。
六、面试标准口述完整版(直接背)
正规相机驱动里,RAW 帧从乒乓 DMA 到软件多帧环形队列不需要内存拷贝。
驱动会预先申请 4 到 8 个统一大小、物理连续的帧缓冲区,组成软件环形内存池。运行时从池中取出两块作为 DMA 硬件乒乓 Buffer,MIPI 直接把 RAW 数据写入这两块内存。一帧接收完成后,只把当前已满的缓冲区地址指针挂入软件就绪队列,同时从空闲队列里再拿一块新 Buffer 替补进 DMA 乒乓,实现动态轮换。
上层 ISP、3A 算法直接操作原始缓冲区地址,全程零拷贝,只传递指针,不搬运像素数据;只有架构简单的低端 MCU 驱动才会做 memcpy 拷贝,高端手机和无人机相机架构都是内存池 + 指针传递的零拷贝设计。
ION Buffer
ION buffer是指用于Linux内核Android系统中的一种物理内存管理方法,是基于DMA的一种内存管理方案。Ion(Input Output Memory Management Unit)是一个内存管理器,可以帮助在Android系统中对物理内存进行管理以及共享。
ION 最初是 Google 为解决 Android 系统内部内存共享碎片化问题而设计的。简单来说,它的核心使命是统一接口和高效共享,但最终因其设计上的“特殊性”而被更通用、更强大的标准框架 DMA-BUF 取代。
为了让你快速了解DMA和ION的核心区别,我先用一个表格对比它们的关键设计:
| 特性维度 | ION | DMA-BUF |
|---|---|---|
| 设计定位 | 专为Android设计的“一站式”内存管理器与共享框架。 | Linux内核主线标准化的缓冲区共享框架,专注于“共享”本身。 |
| 核心架构 | 高度集成。包含了内存分配器(Heaps)、客户端管理、缓冲区共享等所有功能。 | 模块化。自身不分配内存,而是定义标准接口,让其他内存分配器(如CMA、系统堆)作为“出口商”接入。 |
| 使用范围 | 基本局限于 Android 内核及衍生系统。 | 跨架构、跨驱动的通用标准,被图形、多媒体、摄像头等众多子系统广泛使用。 |
| 关键机制 | 通过其内部的 ion_handle 和 ion_client 进行复杂管理。 | 提供标准的附件映射/取消映射接口,在硬件访问前后进行同步,这是其关键设计。 |
| 分配策略 | 分配时即确定并锁定物理内存。 | 支持延迟分配,可以在首次被硬件使用时,综合所有硬件需求来优化内存属性。 |
ION 的诞生与使命
在 Android 4.0 之前,不同芯片厂商(如高通、德州仪器、英伟达)都有自己的一套内存管理接口(如 PMEM、CMEM、NVMAP),这导致了严重的碎片化-1。ION 的提出正是为了解决这一问题,它的主要目标包括:
-
统一硬件内存池:通过定义不同的“堆”(Heap),如连续内存堆、系统内存堆等,为CPU、GPU、摄像头、解码器等不同硬件模块提供一个统一的、动态的内存分配接口-1-5。
-
实现零拷贝高效共享:核心目标是让多媒体数据(如视频帧)在不同硬件模块间传递时,无需在内存间来回复制,极大提升了性能-1。
-
改善安全与管理:通过引用计数管理生命周期,减少内存泄漏,并提供一定的访问控制-1。
向 DMA-BUF 的技术演进
ION 在 Android 内部成功了,但它本质上是一个“大而全”的“非标准”方案。而 Linux 内核社区主推的 DMA-BUF 框架,因其更优秀的设计,最终成为统一标准。这个取代过程是逐步发生的:
-
初步整合(内核 ~3.4):ION 开始进行内部改造,将自己的缓冲区“导出”为 DMA-BUF 的文件描述符。这使得 ION 分配的内存可以以标准方式被其他支持 DMA-BUF 的驱动使用-2。
-
架构重构(内核 4.12~4.14):这是关键一步。ION 移除了自己复杂的
ion_handle和ion_client抽象层。此后,用户空间和内核空间都直接通过 DMA-BUF 的文件描述符 来操作 ION 分配的缓冲区-1-6。ION 自身逐渐“退化”为 Android 内核中的一个特殊的内存分配器后台,而其共享功能完全由 DMA-BUF 框架接管。 -
现状与未来:目前,在 Android 设备上,你仍然会看到 ION,但它更多是以“DMA-BUF 堆”(
dmabuf_heap)的形式存在。它是众多可供 DMA-BUF 框架调用的内存分配后端之一。Linux 内核社区更鼓励使用如system_heap、cma_heap等与厂商无关的标准堆。
总结:为什么会被取代?
ION 被 DMA-BUF 取代是技术发展的必然,根本原因在于两者设计哲学不同:
-
ION 是一个“解决方案”:它针对 Android 的特定问题,提供了一个完整但封闭的解决方案。这导致了它与 Linux 内核主线生态的割裂-10。
-
DMA-BUF 是一个“标准框架”:它不关心内存具体从哪里来,只定义缓冲区如何被安全、高效地共享。这种模块化、标准化的设计,使其具备了跨平台、跨驱动的普适性-10。同时,DMA-BUF 内建的同步机制和延迟分配能力,在处理复杂硬件互操作时更具优势-10。
简单来说,你可以把 ION 理解为一套为某个公司定制的、功能齐全的办公流程。而 DMA-BUF 则是 ISO 发布的一套国际通用办公流程标准。前者虽然一度在公司内运行良好,但为了与外界广泛协作、融入更大的生态,最终必然会选择迁移到后者。
ION buffer提供了多种API来实现动态分配内存的功能。以下是其中几个核心API介绍:
1. ion_alloc:申请连续一段内存空间,并返回物理地址和虚拟地址。函数原型为:
struct ion_handle *ion_alloc(int fd, size_t len, size_t align, unsigned int heap_mask, unsigned int flags);其中,fd是ion设备文件描述符,len是需要申请的内存大小,align是对齐方式,heap_mask是内存类型掩码,flags是内存分配标志位。
2. ion_free:释放已申请的内存,函数原型为:
int ion_free(int fd, struct ion_handle *handle);其中fd是ion设备文件描述符,handle是内存句柄。
3. ion_map:将分配的物理内存映射到用户空间,函数原型为:
void *ion_map(int fd, struct ion_handle *handle, size_t length, unsigned int prot, unsigned int flags, off_t offset);其中fd是ion设备文件描述符,handle是内存句柄,length是映射内存的大小,prot是访问权限,flags是映射标志位,offset是偏移量。
通过这些API,开发者可以方便地实现动态分配内存的功能,并对分配的内存进行管理、操作和释放等操作。同时,在Android系统中,ionbuffer还可以支持多进程之间共享内存资源,极大地提高了应用程序的效率和灵活性。
MMU和IOMMU
IOMMU(Input/Output Memory Management Unit)和MMU(Memory Management Unit)都是用于管理内存映射的设备。
打个比方,假设计算机系统是一个庞大的公司,CPU 是公司的核心决策层,内存是仓库,而各种 I/O 设备(如硬盘、网卡等)就是分布在不同地方的员工。MMU 负责把决策层(CPU)的指令地址准确翻译给仓库(内存),而 IOMMU 则是让这些员工(I/O 设备)能够准确找到仓库(内存)中的货物存放位置。
MMU是在CPU内部实现的硬件,主要负责将虚拟地址转换为物理地址,以便CPU能够正确地访问内存。在操作系统中,MMU通常由内核来管理,通过页表等数据结构维护虚拟地址和物理地址之间的映射关系。
IOMMU则相当于是一个专门针对I/O设备的MMU,它服务的对象是具有直接存储器访问(DMA)能力的 I/O 总线设备与物理内存之间的通信。I/O 设备发出的地址,我们可以称之为设备可见的虚拟地址(也叫设备地址或 I/O 地址),IOMMU 的任务就是把这些地址准确无误地映射到物理地址上,确保每个DMA操作只能访问到被授权的内存区域,并防止恶意程序通过DMA接口修改了任意内存位置的数据。这一过程是硬件层面的,因此可以提供高效的内存保护和隔离。
需要注意的是,并不是所有计算机系统都支持IOMMU技术,而且即使支持,也需要在BIOS或UEFI中进行相应的设置才能启用IOMMU功能。
因此,IOMMU和MMU的最大区别就在于它们所管理的内存区域不同:MMU主要管理CPU与内存之间的映射,而IOMMU则主要负责管理外设与内存之间的映射,但它们的基本工作原理是类似的。
mmap
mmap(memory map)即内存映射,用于将文件或设备的物理内存映射到进程的虚拟地址空间,允许用户态程序通过指针直接访问设备数据或文件内容,从而避免传统read/write系统调用的数据拷贝开销。
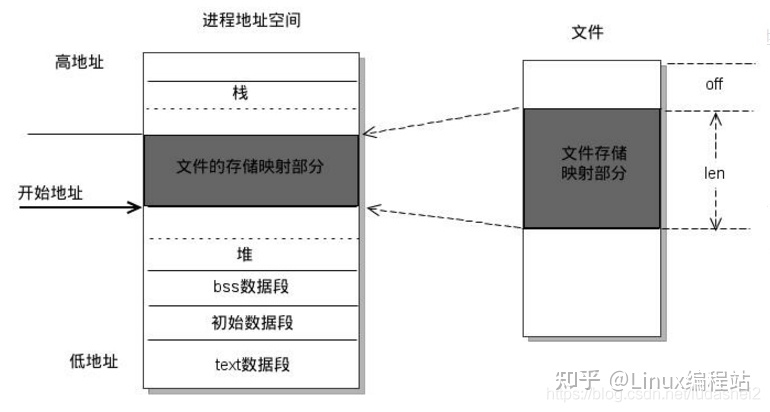
下图表示进程的虚拟地址空间布局,分为多个区域,每个区域存放不同类型的数据。内存映射区域处于堆与栈之间。
mmap和常规文件操作的区别
首先简单回顾一下常规文件操作(调用read/fread等函数)的函数调用过程:
- 进程发起读文件请求。
- 内核通过查找进程文件符表,定位到内核已打开文件集上的文件信息,从而找到此文件的 inode。
- inode 在 address_space 上查找要请求的文件页是否已经缓存在页缓存。如果存在,则直接返回这片文件页的内容。
- 如果不存在,则通过 inode 定位到文件磁盘地址,将数据从磁盘复制到页缓存。之后再次发起读页请求,进而将页缓存中的数据发给用户进程。
写操作也是一样,待写入的 buffer 在内核空间不能直接访问,必须要先拷贝至内核空间内存,再写回磁盘中(延迟写回),也需要两次数据拷贝。
总的来说,常规文件操作为了提高读写效率和保护磁盘,使用了页缓存机制。这样造成读文件时需要先将文件页从磁盘拷贝到页缓存。由于页缓存处在内核空间,不能被用户进程直接寻址,所以还需要将页缓存中数据页再次拷贝到用户空间内存。这样,通过了两次数据拷贝,才能完成进程对文件内容的获取任务。
而使用 mmap 操作文件,创建新的虚拟内存区域和建立文件磁盘地址和虚拟内存区域映射这两步,没有任何文件拷贝操作。而之后访问数据时发现内存中并无数据而发起的缺页异常过程,可以通过已经建立好的映射关系,只使用一次数据拷贝,就从磁盘中将数据传入内存的用户空间中,供进程使用。
总而言之,常规文件操作需要从磁盘到页缓存再到用户主存的两次数据拷贝。而 mmap 操作文件,只需要从磁盘到用户主存的一次数据拷贝,效率更高。
mmap内存映射的实现原理
Linux 内核使用内核数据结构(如vm_area_struct)来表示一个独立的虚拟内存区域,包含起始地址(vm_start)、结束地址(vm_end)、标志位(vm_flags,如可读、可写、可执行)和操作函数指针等,这些属性决定了区域的行为。
由于每块区域在功能、访问权限、生命周期和管理机制上都不同,因此一个进程使用多个 vm_area_struct 结构来分别表示不同类型的虚拟内存区域。各个 vm_area_struct 结构使用链表或者树形结构链接,方便进程快速访问,如下图所示:
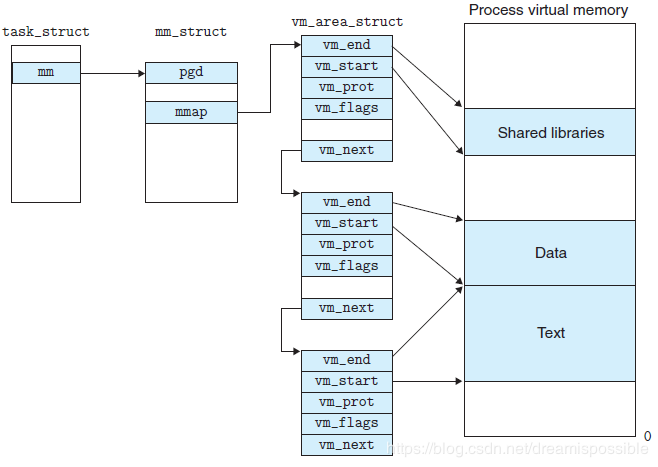
vm_area_struct 结构中包含区域起始和终止地址以及其他相关信息,同时也包含一个 vm_ops 指针,其内部可引出所有针对这个区域可以使用的系统调用函数。这样,进程对某一虚拟内存区域的任何操作需要用到的信息,都可以从 vm_area_struct 中获得。
mmap 函数就是要创建一个新的 vm_area_struct 结构,并将其与文件的物理磁盘地址相连。
mmap内存映射的实现过程
总的来说可以分为三个阶段:
(一)进程启动映射过程,并在虚拟地址空间中为映射创建虚拟映射区域
- 进程在用户空间调用库函数mmap,原型:void *mmap(void *start, size_t length, int prot, int flags, int fd, off_t offset);
- 在当前进程的虚拟地址空间中,寻找一段空闲的满足要求的连续的虚拟地址
- 为此虚拟区分配一个vm_area_struct结构,接着对这个结构的各个域进行了初始化
- 将新建的虚拟区结构(vm_area_struct)插入进程的虚拟地址区域链表或树中
(二)调用内核空间的系统调用函数mmap(不同于用户空间函数),实现文件物理地址和进程虚拟地址的一一映射关系
- 为映射分配了新的虚拟地址区域后,通过待映射的文件指针,在文件描述符表中找到对应的文件描述符,通过文件描述符,链接到内核“已打开文件集”中该文件的文件结构体(struct file),每个文件结构体维护着和这个已打开文件相关各项信息。
- 通过该文件的文件结构体,链接到file_operations模块,调用内核函数mmap,其原型为:int mmap(struct file *filp, struct vm_area_struct *vma),不同于用户空间库函数。
- 内核mmap函数通过虚拟文件系统inode模块定位到文件磁盘物理地址。
- 通过remap_pfn_range函数建立页表,即实现了文件地址和虚拟地址区域的映射关系。此时,这片虚拟地址并没有任何数据关联到主存中。
(三)进程发起对这片映射空间的访问,引发缺页异常,实现文件内容到物理内存(主存)的拷贝
注:前两个阶段仅在于创建虚拟区间并完成地址映射,但是并没有将任何文件数据的拷贝至主存。真正的文件读取是当进程发起读或写操作时。
- 进程的读或写操作访问虚拟地址空间这一段映射地址,通过查询页表,发现这一段地址并不在物理页面上。因为目前只建立了地址映射,真正的硬盘数据还没有拷贝到内存中,因此引发缺页异常。
- 缺页异常进行一系列判断,确定无非法操作后,内核发起请求调页过程。
- 调页过程先在交换缓存空间(swap cache)中寻找需要访问的内存页,如果没有则调用nopage函数把所缺的页从磁盘装入到主存中。
- 之后进程即可对这片主存进行读或者写的操作,如果写操作改变了其内容,一定时间后系统会自动回写脏页面到对应磁盘地址,也即完成了写入到文件的过程。
注:修改过的脏页面并不会立即更新回文件中,而是有一段时间的延迟,可以调用msync()来强制同步, 这样所写的内容就能立即保存到文件里了。
mmap内存映射的使用场景
- 直接内存访问与硬件寄存器映射:mmap常用于直接访问硬件寄存器或物理内存区域,例如在嵌入式系统中,通过打开特殊设备文件(如
/dev/mem)并映射特定物理地址,程序可直接读写外设寄存器,这在驱动开发或嵌入式底层编程中至关重要,能高效控制外设(如GPIO、定时器)或内存映射I/O设备。 - 高效文件与设备数据处理:对于需要频繁访问大文件或设备数据的场景(如图像处理、传感器数据采集),mmap可将文件或设备内容直接映射到虚拟内存,程序通过指针操作即可实现零拷贝访问,显著提升效率并减少系统调用开销。
- 进程间共享内存:mmap支持多个进程映射同一文件或共享内存对象,实现高效数据共享,这在嵌入式系统中常用于多进程协作场景(如数据采集与处理模块间通信),避免复杂IPC机制的开销。
自己实现对应设备文件的mmap函数
对于开发linux驱动的工程师来说,需自己实现对应设备文件的mmap函数,例如framebuffer这种设备需要较高频率大数据读写,因此不能容忍内核空间到用户空间的数据拷贝,因此驱动需开发自己的mmap函数供用户进程调用,驱动mmap实现流程大致为:
- 通过kmalloc, get_free_pages, vmalloc等分配一段虚拟地址。
- 如果是使用kmalloc, get_free_pages分配的虚拟地址,那么使用virt_to_phys()将其转化为物理地址,再将得到的物理地址通过”phys>>PAGE_SHIFT”获取其对应的物理页面帧号。或者直接使用virt_to_page从虚拟地址获取得到对应的物理页面帧号。如果是使用vmalloc分配的虚拟地址,那么使用vmalloc_to_pfn获取虚拟地址对应的物理页面的帧号。
- 对每个页面调用SetPageReserved()标记为保留才可以。
- 通过remap_pfn_range为物理页面的帧号建立页表,并映射到用户空间。
 //内存分配
 buffer = (unsigned char *)kmalloc(PAGE_SIZE,GFP_KERNEL);
 //将该段内存设置为保留
 SetPageReserved(virt_to_page(buffer));
 //得到物理地址
 phys = virt_to_phys(buffer);
 //将用户空间的一个vma虚拟内存区映射到以page开始的一段连续物理页面上
 remap_pfn_range(vma,
                 vma->vm_start,
                 phys >> PAGE_SHIFT,//第三个参数是页帧号,由物理地址右移PAGE_SHIFT得到
                 vma->vm_end - vma->vm_start,
                 vma->vm_page_prot)
原文链接:https://zhuanlan.zhihu.com/p/536690570
https://cloud.tencent.com/developer/article/2420465?policyId=1004
https://cloud.tencent.com/developer/article/2309784
kernel里面有哪些分配内存的方式,又是怎么给到用户态使用的?
Linux内核中实现的内存分配函数有很多,下面列举几个常用的:
1. kmalloc:分配小块连续物理内存。kmalloc调用内核的伙伴算法(Buddy System)来管理物理页面,以保证分配的内存是物理上连续的。虚拟内存地址与真实的物理地址只有一个固定的偏移,因为存在较简单的转换关系,所以对申请的内存大小有限制,不能超过128KB。
2. vmalloc:分配大块的虚拟地址空间。vmalloc将分配的内存映射到虚拟地址空间中的一页页框上,虽然这些页框可能不是物理上连续的,因此对申请的内存大小没有限制,如果需要申请较大的内存空间就需要用此函数了。vmalloc()相比较于kmalloc()效率较低,因为获得的页必须转换为虚拟地址空间上连续的页,必须专门建立页表项。该函数可能睡眠,因此不能从终端上下文中调用,也不能从其他不允许阻塞的情况下进行调用。
3. kzalloc:在kmalloc的基础上用0填充新分配的内存。它在分配时与kmalloc相同,但会自动将新分配的内存清零。
4. krealloc:重新分配一个已经分配的内存块。它可以增加、缩小或移动内存块的大小,并且会保留原内存块中的数据。
除了上述内存分配函数外,Linux内核还提供了一些特殊的内存分配函数,包括:
1. ioremap:将设备物理地址映射到内核虚拟地址空间上。这种内存分配通常用于驱动程序中对设备寄存器的访问,它可以将设备硬件地址映射到内核虚拟地址空间中,并将返回的虚拟地址用于访问设备寄存器。这样就能够避免在内核中直接访问物理设备地址所带来的安全问题。
需要注意的是,使用ioremap时需要小心,因为它会绕过内存保护机制,可能导致系统的安全性问题。因此,在使用ioremap时应该特别注意安全问题,并且只有在需要直接访问硬件寄存器时才使用它。
2. dma_alloc_coherent:为设备分配连续物理内存区域。这种内存分配通常用于驱动程序中进行DMA操作。
一般情况下,内存只有在要被 DMA 访问的时候才需要物理上连续,但为了性能上的考虑,内核中一般使用 kmalloc(),而只有在需要获得大块内存时才使用 vmalloc()。例如,当模块被动态加载到内核当中时,就把模块装载到由 vmalloc() 分配的内存上。
v4l2设备架构
v4l2(Video4Linux2)是一个开源的视频设备驱动程序框架,具有高度的灵活性和可扩展性,能够支持各种视频设备的操作和管理。v4l2框架是Linux内核中一个重要的子系统,在多媒体应用、图像处理等领域得到广泛应用。其主要特点包括:
- v4l2_device:这个是整个输入设备的总结构体,可以认为它是整个 V4L2 框架的入口,充当驱动的管理者以及入口监护人。由该结构体引申出来 v4l2_subdev。用于视频输入设备整体的管理,有多少输入设备就有多少个v4l2_device抽象(比如一个USB摄像头整体就可以看作是一个 V4L2 device)。再往下分是输入子设备,对应的是例如 ISP、CSI、MIPI 等设备,它们是从属于一个 V4L2 device 之下的。
- media_device:用于运行时数据流的管理,嵌入在 V4L2 device 内部,运行时的意思就是:一个 V4L2 device 下属可能有非常多同类型的子设备(两个或者多个 sensor、ISP 等),那么在设备运行的时候我怎么知道我的数据流需要用到哪一个类型的哪一个子设备呢。这个时候就轮到 media_device 出手了,它为这一坨的子设备建立一条虚拟的连线,建立起来一个运行时的 pipeline(管道),并且可以在运行时动态改变、管理接入的设备。
- v4l2_ctrl_handler:控制模块,提供子设备(主要是 video 和 ISP 设备)在用户空间的特效操作接口,比如你想改变下输出图像的亮度、对比度、饱和度等等,都可以通过这个来完成。
- vb2_queue:提供内核与用户空间的 buffer 流转接口,输入设备产生了一坨图像数据,在内核里面应该放在哪里呢?能放几个呢?是整段连续的还是还是分段连续的又或者是物理不连续的?用户怎么去取用呢?都是它在管理。

总之,v4l2框架是一个功能强大的视频设备驱动程序框架,在Linux系统中得到了广泛的应用。通过v4l2框架,开发者可以方便地对接不同类型的视频设备,并实现各种视频数据的获取、处理和显示,从而为多媒体应用和图像处理等领域提供了稳定、高效的支持。
在v4l2框架中,缓存管理是通过数据缓存队列来实现的。具体来说,视频设备通过DMA等方式将视频帧数据传输到缓存队列中,应用程序则从该队列中读取数据进行处理或显示。v4l2提供了一组API来管理缓存队列,包括:
- VIDIOC_REQBUFS:此命令可设置设备请求缓存队列,也就是告诉设备需要多少个缓存空间。
- VIDIOC_QUERYBUF:此命令可查询缓存区,获取缓存区的地址、长度、是否被使用等信息。及从设备端获取数据缓存的指针和大小,以便于开发者在应用程序中进行处理或显示。
- VIDIOC_QBUF:此命令可把已经被应用程序处理后的缓存放回缓存队列。
- VIDIOC_DQBUF:此命令则可以从设备队列中取出一个缓存,以便设备把视频帧数据DMA传输到该缓存中,交由应用程序进行后续处理或显示。
通过这些API,开发者可以方便地进行视频帧数据的缓存管理,使得数据传输效率更高,同时也可以有效地减轻系统负担,提高了多媒体应用和图像处理等领域的运算性能。
原文链接:https://blog.csdn.net/u013904227/article/details/80718831
GPIO用法
GPIO(General Purpose Input Output),通用输入输出。有时候简称为“IO口”。通用,就是说它是万金油,干什么都行。输入输出,就是说既能当输入口使用,又能当输出口使用。端口,就是元器件上的一个引脚。怎么用?写软件控制。
常见用法:
1. GPIO做开关控制,是最常见的应用场景。
2. GPIO做中断
3. 用作按键输入
4. 用作I2C接口,通过软件控制GPIO口拉高拉低来模拟I2C的波形和时序
5. GPIO口输出PWM波,跟当作I2C使用的性质上是一样的。控制GPIO口 定时拉高拉低,就可以输出PWM波形。
6.GPIO用作ADC采样,采集电池电压
原文链接:https://zhuanlan.zhihu.com/p/80096604
CSI与CCI
CSI(Camera Serial Interface,相机串行接口)和CCI(Camera Control Interface,相机控制接口)是MIPI联盟为相机系统定义的两个核心接口,分别负责高速图像数据传输和低速率控制命令传输。。但是它们之间有一些区别,下面对它们做一简要介绍:
- CSI:CSI是一种用于连接图像传感器和处理器(如 SoC 或 GPU)的串行接口协议。它主要负责图像数据的传输,包括同步信号、像素数据、控制信号等。CSI接口可以提供高带宽、低功耗的串行数据传输方式,支持多路并行数据传输。
- CCI:CCI是一种用于配置和控制相机模块的接口协议。它通过 I2C 总线发送指令来配置相机模块的各项参数,如曝光时间、白平衡、增益等,用于对图像进行预处理或者后处理。
在实际应用中,CSI 接口常常被用于连接 CMOS 摄像头或者 ISP 芯片,而 CCI 接口则用于与 CMOS 摄像头上的芯片进行通讯和控制。例如,在运行 Android 操作系统的移动设备中,CSI 接口通常用于连接摄像头 CMOS 传感器和处理器,而 CCI 接口则用于向 CMOS 芯片发送控制指令,以调整相关参数。

CSI(Camera Serial Interface,相机串行接口)
MIPI CSI-2是目前应用最广泛的CSI标准,它采用分层的架构,负责将图像传感器(Sensor)产生的原始像素数据,可靠、高效地传输给图像信号处理器(VFE/ISP)。其核心工作层及作用如下表所示:
| 层级 | 名称 | 核心功能与作用 | 关键说明 |
|---|---|---|---|
| 物理层 (PHY Layer) | D-PHY 或 C-PHY | 电气信号转换与传输:将数字信号转换为差分电平在物理线对上串行传输,并提供同步时钟。 | 决定了接口的速率、功耗和抗干扰能力。是数据流的“高速公路”。 |
| 协议层 (Protocol Layer) | Lane管理层、低层协议等 | 数据包化、调度与错误校验:将像素数据打包,分配至多条数据通道传输,并加入校验码。 | 确保数据有序、可靠传输,是数据流的“交通指挥系统”。 |
| 应用层 (Application Layer) | 像素到字节的转换、格式封装 | 数据格式化:将传感器输出的像素(如RAW)按约定格式打包,并添加行、帧等信息。 | 决定了上层软件接收到的数据结构,是数据流的“标准化包装”。 |
数据传递流程详解
图像数据从传感器到图像处理前端IFE的传递,是自下而上(从应用层到物理层)再逆向解析的过程:
-
源端(传感器端)处理
-
应用层:传感器将感光生成的原始像素阵列(如Bayer RAW),按照CSI-2标准规定的格式,加上数据包头/尾、帧开始/结束等标识,组装成字节流。
-
协议层:将字节流分割、组织成更小的数据包,并为每个包添加错误校验码。如果使用多路通道(Lane),该层负责将数据包分流到不同的通道上。
-
物理层:将数字数据包转换成适合高速串行传输的差分电信号,通过一对对的物理连线(如D0+/D0-)发送出去,同时传输同步时钟信号。
-
-
通道传输
-
信号通过PCB板上的走线从传感器传输至处理器(SoC/IFE)。
-
-
接收端(IFE/SOC端)处理
-
物理层:接收差分信号,将其还原为数字数据包,并利用时钟信号进行同步和数据恢复。
-
协议层:对来自各条通道的数据包进行重新排序、合并,检查校验码以确认传输过程有无错误。
-
应用层:剥离数据包中的协议头尾信息,将纯净的、格式化好的像素数据字节流提交给IFE/ISP的硬件模块进行后续的图像处理(如降噪、色彩插值等)。
-
重要补充说明
-
CSI是传输通道:它主要解决“如何传”的问题,不负责提升画质或进行图像处理。画质由传感器本身和VFE的算法决定。
-
核心价值:这种分层设计实现了传感器与处理器之间的解耦。只要遵循同一标准(如CSI-2),不同厂商的传感器和处理器可以相互兼容。
MIPI D-PHY
MIPI D-PHY不是一个独立的硬件芯片,而是一个可以被集成到不同芯片内部的“硬件IP核”或“物理层模块”。 它在图像数据链路上的实现位置非常明确。
为了让你一目了然,D-PHY的实现位置取决于它在链路中的角色:
| 实现位置 | 角色 | 说明 |
|---|---|---|
| 摄像头端(发送端) | 发射器(TX) | 集成于图像传感器或加串器芯片内部。 |
| 处理器端(接收端) | 接收器(RX) | 集成于主处理器SoC内部,即高通的CSIPHY模块。 |
详细解释与工作流程
-
在摄像头/加串器端(发送端)
-
实现位置:在当今主流的摄像头模组中,MIPI D-PHY的发射器通常直接集成在图像传感器芯片内部。传感器将生成的像素数据,直接通过其内置的D-PHY TX模块转换为串行差分信号输出。
-
与加串器的关系:在车载等需要长距离传输的场景,传感器输出的短距离MIPI CSI-2信号(基于D-PHY)会立即被加串器芯片接收。一些加串器内部也集成了D-PHY 接收器,用以接收传感器的信号,然后经过协议转换,最终通过其专用SerDes协议(如GMSL)发送出去。
-
-
在处理器SoC端(接收端)
-
实现位置:在手机或车机的主处理器(如高通骁龙、瑞萨R-Car等)内部,MIPI D-PHY的接收器被作为一个标准IP核集成,这就是高通的CSIPHY模块的核心组成部分。
-
具体工作:CSIPHY = CSI + PHY,其中的 “PHY” 指的就是MIPI D-PHY(或C-PHY)的物理层电路。它负责接收差分信号,进行时钟数据恢复、串并转换,将数据流交给上层的CSID处理。
-
完整信号流示例
以一个车载前视摄像头为例,数据流向如下:
-
传感器内部:图像传感器芯片 → 其内置D-PHY TX → 输出MIPI CSI-2差分信号。
-
板级传输:该信号通过短距离FPC线缆连接到加串器芯片。
-
加串器内部:加串器的D-PHY RX接收信号 → 内部逻辑处理 → 其GMSL串行器 → 通过同轴电缆输出。
-
解串器到SoC:解串器接收GMSL信号并还原为MIPI CSI-2信号 → 通过板级走线发送给高通SoC的MIPI CSI接口。
-
SoC内部:信号进入CSIPHY模块(D-PHY RX) → CSID模块 → IFE/ISP。
核心总结
-
MIPI D-PHY是一个标准物理层IP,像乐高积木一样,被集成到需要MIPI接口功能的各类芯片中。
-
在高通平台,负责接收信号的D-PHY RX就是CSIPHY硬件模块的一部分。
-
这种集成化设计是实现设备小型化、低功耗和高可靠性的关键。
高通SOC的CSIPHY和CSID(IFE/SOC端的MIPI PHY)
CSIPHY和CSID是高通移动平台或车载SoC芯片内部两个独立但又紧密协作的硬件模块(或称硬件IP核)。
简单来说,如果把从摄像头传感器进入SoC的数据流比作快递包裹的运送:
-
CSIPHY 是负责签收和拆开外部包裹的“前台”,处理物理层的电信号。
-
CSID 是负责核对包裹信息、分拣派发的“物流中心”,处理协议层的解析与分发。
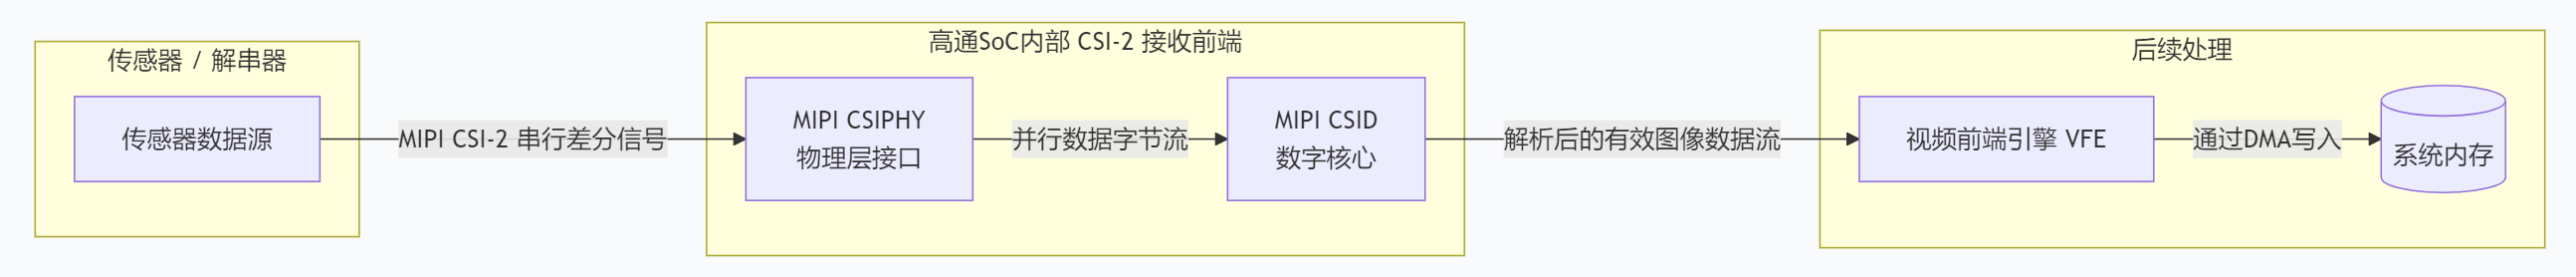
下图清晰地展示了它们如何协同工作,共同构成CSI-2数据接收的前端:
核心差异与分工
为了更直观地理解,以下是这两个模块在功能、层级和关注点上的具体对比:
| 模块 | 全称 | 核心职责 | 工作层级 | 关键关注点 |
|---|---|---|---|---|
| CSIPHY | Camera Serial Interface PHYsical Layer | 负责接收MIPI D-PHY/C-PHY物理层信号,进行时钟数据恢复、串并转换,输出并行的数据字节流。 | 物理层 | 信号完整性、电气参数、时序、抗干扰、功耗模式切换(高速/低功耗)。 |
| CSID | Camera Serial Interface Digital Core | 负责解析CSIPHY传来的字节流,根据MIPI CSI-2协议拆包,提取有效像素数据,分离虚拟通道,进行错误校验,并分发给后端的VFE。 | 协议层 | 数据包解析、虚拟通道分离、数据格式识别、错误检测、多路流分发。 |
二者关系与工作流程
在高通SoC的典型设计中:
-
集成与依赖:两者通常作为一个完整的CSI-2接收器子系统协同设计,CSIPHY的输出直接连接到CSID的输入。没有CSIPHY,信号无法正确进入SoC;没有CSID,原始字节流无法被解析成可用数据。
-
典型工作流:
-
外部传感器或解串器发送MIPI CSI-2差分信号。
-
CSIPHY:完成信号接收、时钟恢复、串并转换。
-
CSID:解析数据包头、分离虚拟通道(用于多摄像头)、校验数据、提取有效载荷(即RAW/YUV等图像数据)。
-
解析后的数据流通过SoC内部总线,被送往视频前端引擎进行处理,最终通过DMA写入内存。
-
-
配置关系:驱动配置时,CSIPHY的配置(如通道数、数据速率)必须严格匹配传感器的物理输出。而CSID的配置(如虚拟通道映射、数据格式)则需匹配数据包的内容。两者配置必须一致,数据流才能畅通。
总结
因此,CSIPHY和CSID是两个分工明确、前后衔接的硬件模块。CSIPHY是物理接口的“门卫”,确保信号准确无误地进入;CSID是数据解析的“大脑”,确保进入的数据能被正确理解和分发。它们共同构成了高通平台处理摄像头数据的第一道关键硬件门槛。
MIPI C-PHY 和 D-PHY 的区别
D-PHY和C-PHY是MIPI联盟为移动设备、相机等高速串行接口定义的两种不同的物理层(PHY) 标准。它们是CSI-2等协议得以运行的底层“高速公路”。你可以将它们理解为两种不同的 “运输系统” ,目标都是把数据从A点高速运到B点,但采用的“车辆”、“道路”和“驾驶规则”截然不同。
下面是它们核心区别的详细对比:
| 维度 | MIPI D-PHY | MIPI C-PHY |
|---|---|---|
| 核心编码与传输机制 | 基于时钟-数据的并行传输 • 每条数据通道(Data Lane)由一对差分信号线(Dp/Dn)组成。 • 需要一条独立的时钟通道(Clock Lane,也是一对差分线)来同步。 • 数据传输采用时钟双边沿采样(DDR),效率高。 | 基于符号编码的嵌入式时钟传输 • 每条通道(Lane)由三根线(A, B, C)组成,形成一个三相系统。 • 没有独立的时钟通道,时钟信息通过三根线之间的电压状态跳转来编码和恢复。 • 采用16进制符号编码,每个符号(3位电压状态)传输多位数据。 |
| 物理线数与结构 | 结构相对简单、独立 • N条数据通道 = 2N根线 + 2根时钟线。 • 例如,1个时钟通道+2个数据通道共需6根线。 | 结构更集成、线数更少 • N条通道 = 3N根线,完全省去了时钟线。 • 例如,同样实现2条数据通道的传输,仅需6根线(但机制完全不同)。在同等线数下,C-PHY可提供更高的带宽。 |
| 频谱效率 | 中等 • 每条数据线在每个时钟周期(双边沿)传输2比特数据。 | 非常高 • 因其独特的16进制编码,每根线每个符号周期可传输约2.28比特数据。这是其高带宽的核心秘密。 |
| 抗干扰与信号完整性 | 较好。经典的差分信号对共模噪声有很好的抑制作用。 | 理论上更强。三相信号在传输中任何时刻总电流恒定,电磁辐射(EMI)更低,且对共模噪声和串扰有更好的容忍度。 |
| 复杂性与功耗 | 相对较低 • 电路设计成熟,复杂度主要集中在时钟恢复和DDR采样上。 | 相对较高 • 发射端编码和接收端解码逻辑复杂,对模拟电路设计(如比较器)要求高,可能带来更高的初始功耗。但其高传输效率在完成相同任务时可能更省电。 |
| 应用趋势与场景 | 主流且经典,应用历史长,生态成熟。广泛用于摄像头(CSI-2)和显示屏(DSI)。是大多数传统设计的第一选择。 | 为超高分辨率、高刷新率而生。正迅速成为高端智能手机主摄像头、4K+/高刷新率屏幕的标配,以满足其巨大的数据吞吐需求。 |
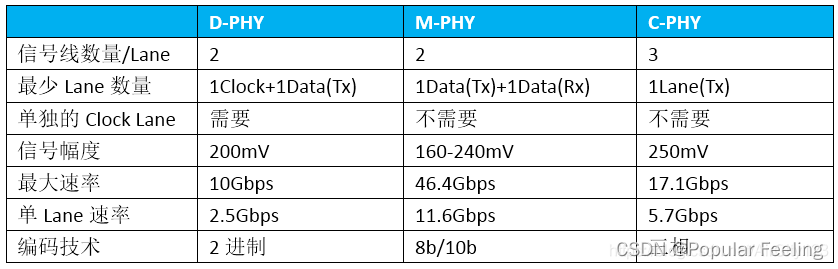

参考链接:https://blog.csdn.net/daocaokafei/article/details/127825318
YUV420和YUV422的区别
YUV420 和 YUV422 都是数字视频中的色度子采样格式,它们的主要区别在于颜色分量的采样方式以及输出图像的质量和大小。
在 YUV420 中,色度(Cb 和 Cr)分量的采样率比亮度(Y)分量低,即每 4 个亮度样本只有 1 个 Cb 和 1 个 Cr 样本。具体来说,Cb 和 Cr 分量的采样方式是在水平和垂直方向上各隔一个亮度行或列进行采样,这种采样方式称为 4:2:0。由于色度分量的采样率较低,因此 YUV420 的数据量相对较小,适用于存储空间和传输带宽有限的应用场合。但其缺点是色彩信息的精度不如 YUV422,会导致图像细节损失或色块等视觉问题。
而在 YUV422 中,色度分量的采样率比 YUV420 更高,即每 2 个亮度样本只有 1 个 Cb 和 1 个 Cr 样本。具体来说,Cb 和 Cr 分量的采样方式是在水平方向上各隔一个亮度样本进行采样,这种采样方式称为 4:2:2。相比 YUV420,YUV422 的色彩信息更加精确,可以提供更高的图像质量和细节清晰度,但数据量也更大,适用于存储空间和传输带宽相对充足的应用场合。
总之,YUV420 和 YUV422 的区别在于色度分量的采样率不同,导致输出图像的质量和大小存在差异。选择哪种子采样格式应根据应用场景和要求来决定。
怎么从RGB转为灰度图?
从 RGB 转为灰度图有多种方法,其中比较常用的是加权平均法。该方法通过对 RGB 三个分量进行加权平均,得到一个单通道的灰度图像。通常采用下面的公式进行计算:
Gray = 0.299 * R + 0.587 * G + 0.114 * B
其中,R、G、B 分别表示红色、绿色、蓝色分量的值(一般范围在 0~255 之间),0.299、0.587、0.114 是经过调整的归一化系数,是通过对人眼对不同颜色的敏感度进行统计和调整得出的,可以较好地模拟人眼对颜色的感知。
具体转换的步骤如下:
1. 读入 RGB 图像的像素值,按顺序依次取出每个像素(包含 R、G、B 三个分量)。
2. 对于每个像素,使用上述公式计算出它的灰度值,即 Gray,注意需要将结果四舍五入取整后转换为整型数据类型。
3. 将计算得到的灰度值作为像素的值,存储在同样位置的灰度图像中。
4. 重复执行上述操作,直到遍历完整个 RGB 图像,并得到一个灰度图像。
需要注意的是,加权平均法只是一种常见的 RGB 到灰度图的转换方法,其它的转换方法也可以使用。例如,还可以使用亮度平均法、最大值法、最小值法等进行转换。此外,也可以使用现成的图像处理库或软件来实现 RGB 到灰度图的转换。
加串器和解串器
视频加串器(Serializer)和解串器(Deserializer,简称SerDes)在车载相机系统中是独立的硬件芯片模块,它们通过串行链路连接摄像头与主处理器(如高通SoC)。 其核心作用是解决远距离、高带宽、抗干扰的视频信号传输问题。
其在高通平台上的典型工作流程如下:
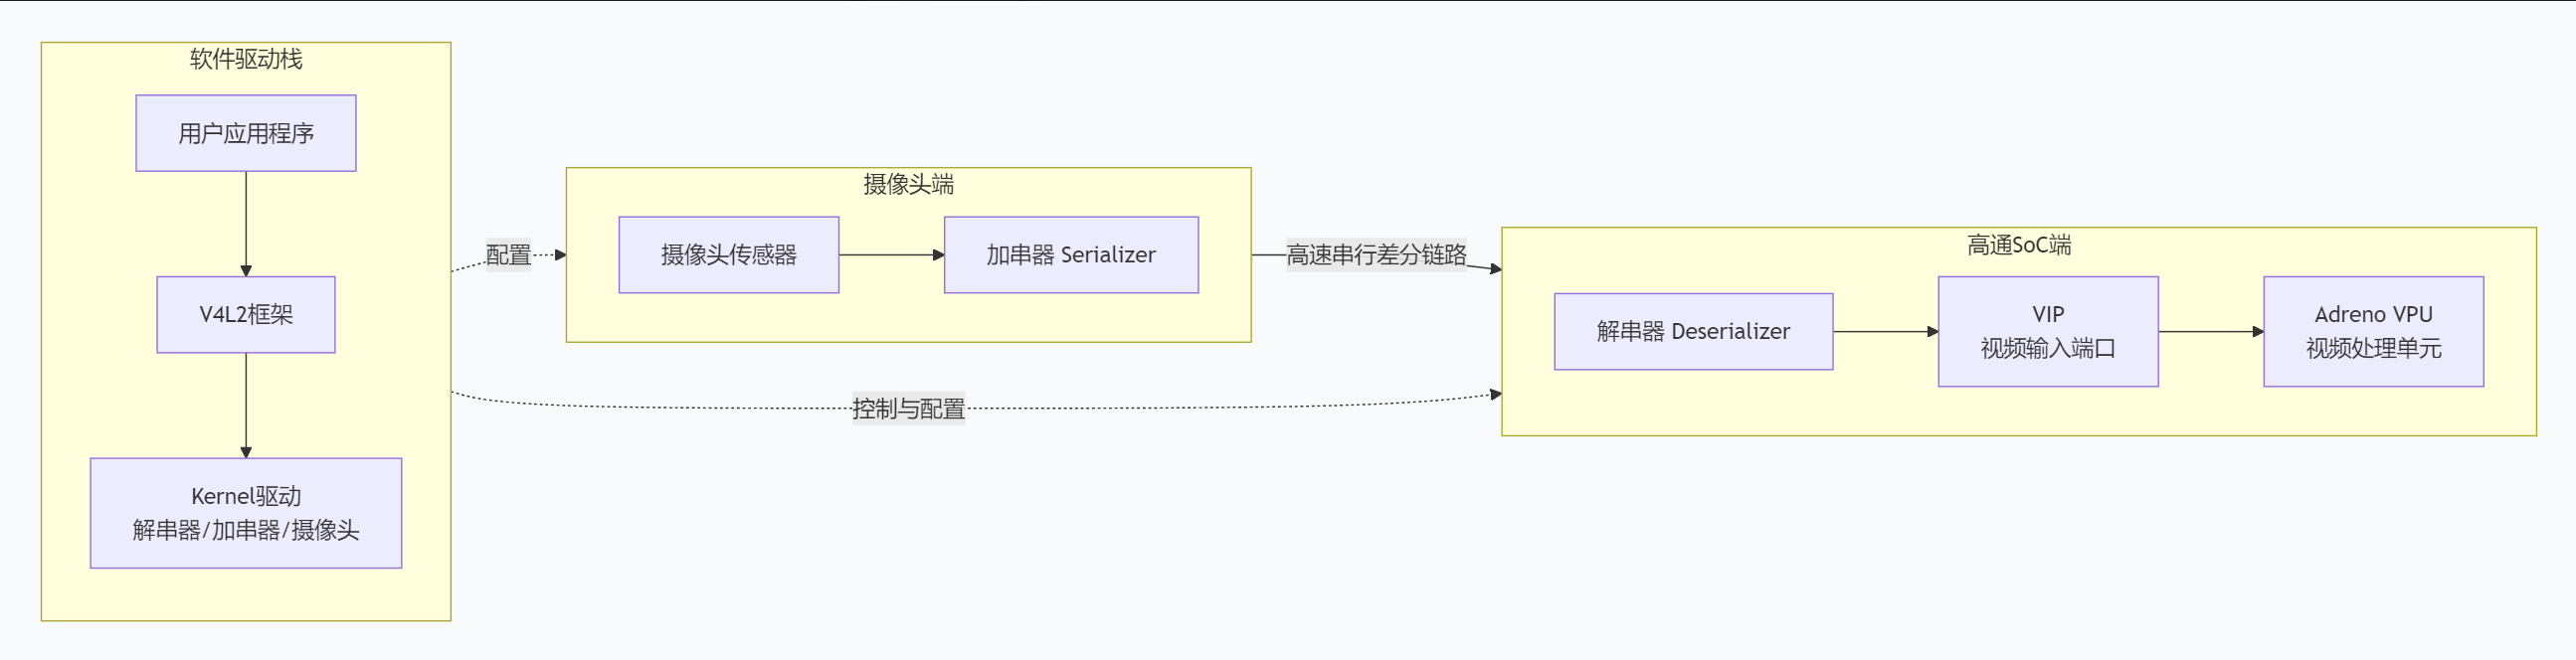
1. 核心硬件模块:独立的SerDes芯片
在车载架构中,摄像头模组通常由图像传感器和加串器芯片集成在一起,安装在车外(如后视镜、车牌附近)。而解串器芯片则安装在车内,靠近高通等主处理器。它们是独立的物理芯片,例如:
-
加串器示例:MAX96705, 专为汽车摄像头设计,将并行视频数据转换为高速串行信号。
-
解串器示例:MAX9286或MAX96706, 接收串行信号,将其还原为并行数据,并输出给处理器。
它们通过同轴电缆或屏蔽双绞线连接,可稳定传输15米以上,并能双向传输控制信号(如I2C)。
2. 工作流程与高通代码框架解析
结合上图,其工作流程和对应的软件驱动可分为以下几个层面:
第1步:硬件初始化与配置
系统上电后,高通SoC(通过I2C等总线)首先配置解串器,解串器再通过串行链路中的同一条电缆,将配置命令转发给远端的加串器,并最终配置摄像头传感器(如设置分辨率、帧率)。这是一个典型的“主从”配置链。
第2步:视频流捕获与传输
摄像头传感器产生并行视频数据流,由加串器转换为高速、抗干扰的串行差分信号,通过线缆传输。解串器接收后,进行时钟恢复、均衡和解串,将视频数据还原为标准的并行格式(如MIPI CSI-2),发送给高通SoC的视频输入端口(VIP)。
第3步:驱动软件栈(以高通Linux为例)
高通平台的摄像头驱动通常基于Linux的V4L2(Video for Linux 2)框架构建。
-
驱动组成:软件上需要三个关键驱动:解串器驱动、加串器驱动和摄像头传感器驱动。它们被注册到内核中,形成完整的控制链。
-
数据通路:如上图所示,视频数据经解串器进入SoC的VIP模块后,由VIP驱动负责采集,数据可送至Adreno VPU进行硬件编解码或处理。
-
用户控制:应用程序通过标准的V4L2接口调用,最终由内核中的这些驱动协同操作硬件。
第4步:灵活性与模块化
一项相关专利提出了一种模块化驱动方法:将所有可能的摄像头、加串器驱动预先编译成模块文件,系统根据实际检测到的硬件标识动态加载对应的驱动,而无需重新编译整个系统内核,提高了硬件兼容性和更换的灵活性。
3. 关键设计要点
-
链路协同性:加串器与解串器必须成对使用,且型号需相互兼容,支持相同的协议(如GMSL)。
-
控制通道:除了高速视频通道,SerDes链路还集成了低速、双向的控制通道,用于传输I2C/UART命令,实现远程配置和状态读取。
-
信号完整性:车载环境恶劣,SerDes芯片具备预加重、均衡、误码检测与恢复等功能,以应对长距离传输和电磁干扰。
多摄像头时的多对一情况(多加串器,一个解串器)
在车载系统中,一个高通车机SoC确实通常只有一个解串器芯片,但这个解串器芯片普遍设计为支持多路输入(通常是4路)。多个摄像头(及各自的加串器)共享这一个解串器。
下图清晰展示了两种实现这种“多对一”连接的典型硬件拓扑:
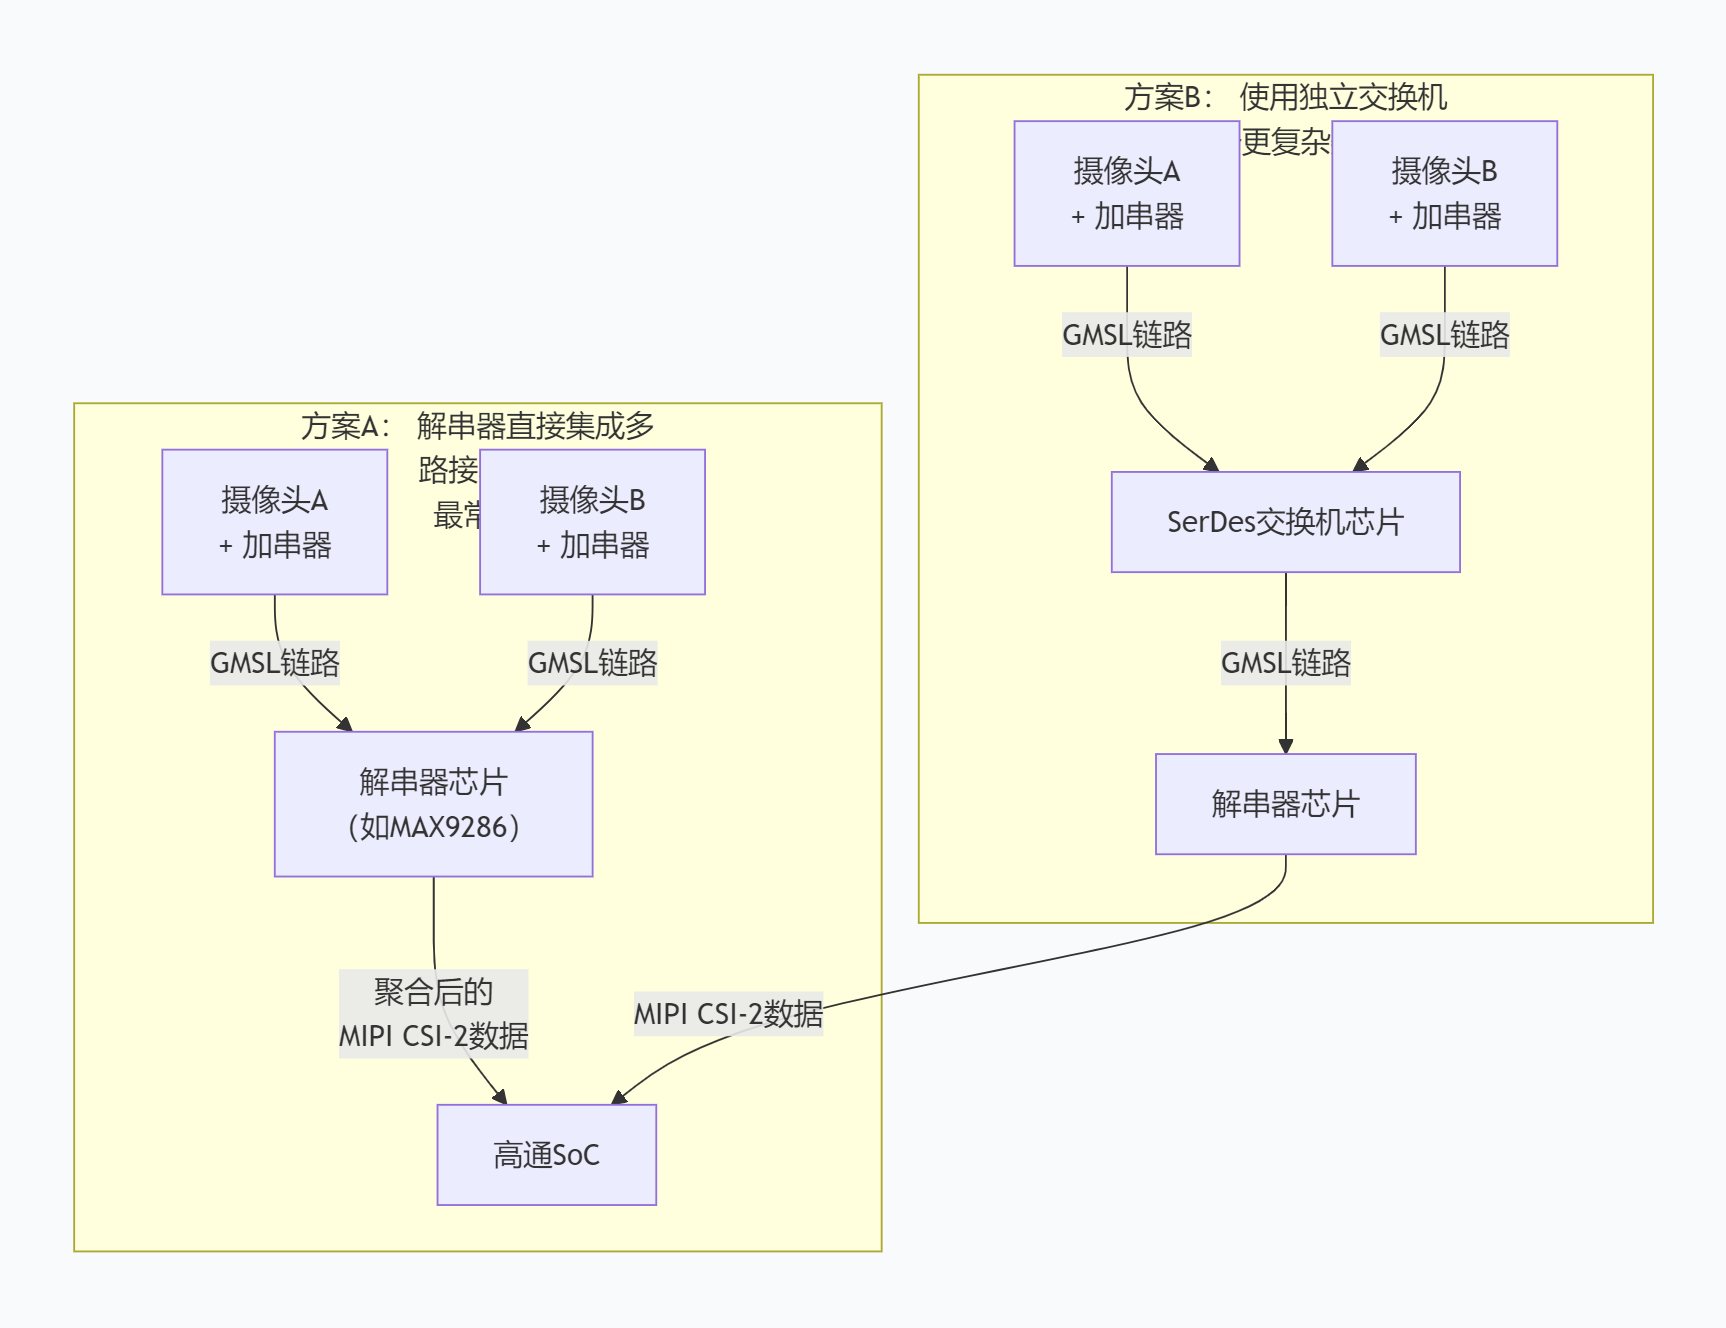
1. 硬件连接:如何实现“多对一”?
-
主流方案:多数情况下,采用方案A。例如MAX9286这类解串器芯片,内部集成了4个独立的接收器。这意味着它可以同时通过4条独立的GMSL线缆,连接4个不同位置的摄像头模组(每个模组包含传感器和对应的加串器芯片,如MAX96705)。解串器在内部将这4路视频流处理后,再通过1路或2路MIPI CSI-2输出给高通SoC。
-
扩展方案:对于需要超过4路摄像头的高端车型,会采用方案B。先使用一个SerDes交换机芯片(如MAX9296)汇聚更多路(如6-12路)摄像头信号,再通过一到两条GMSL链路连接到下游的解串器。
2. 软件与协议:如何区分不同摄像头?
关键在于两个核心机制:虚拟通道 和 I2C地址映射。
-
虚拟通道:这是MIPI CSI-2协议标准的一部分。每个摄像头的视频流在被加串器发送时,就会被赋予一个唯一的虚拟通道标识符。当多路数据在解串器内部被复用到同一组MIPI CSI-2总线上时,每一帧数据都携带这个标签。高通SoC的摄像头控制器(CSIPHY/CSID)能根据这个标签,将混合的数据流重新分离,并路由到不同的软件处理通道。
-
I2C地址映射:为了实现远程配置,解串器还扮演着 “I2C集线器/桥” 的角色。其内部有一个地址转换表,可以将来自高通SoC的一条本地I2C总线上的访问,根据目标地址,准确转发到对应摄像头的加串器,进而控制其传感器。
3. 高通驱动框架中的关键配置
驱动需要正确描述上述硬件拓扑。在高通Linux内核的设备树中,一个典型的4摄像头配置会像这样:
// 简化示例,展示结构
&cam_cci { // 高通Camera Control Interface (基于I2C)
    // 摄像头传感器1:前视
    camera_front: qcom,camera@10 {
        reg = <0x10>; // SoC本地I2C看到的地址
        ... // 传感器属性
        ports {
            port {
                camera_front_endpoint: endpoint {
                    remote-endpoint = <&deser_0>; // 连接到解串器的端口0
                    data-lanes = <1 2 3 4>;
                    virtual-channel = <0>; // 关键!虚拟通道 0
                };
            };
        };
    };

    // 摄像头传感器2:后视
    camera_rear: qcom,camera@11 {
        reg = <0x11>;
        ...
                virtual-channel = <1>; // 关键!虚拟通道 1
        ...
    };

    // 解串器本身也是一个I2C设备
    deser: maxim,max9286@60 {
        reg = <0x60>; // 解串器自身的I2C地址
        compatible = "maxim,max9286";
        ... // 解串器属性
        ports {
            // 解串器的4个输入端口
            port@0 { endpoint { remote-endpoint = <&camera_front_endpoint>; }; };
            port@1 { endpoint { remote-endpoint = <&camera_rear_endpoint>; }; };
            ... // 端口2,3
            // 解串器的1个输出端口,连接SoC
            port@4 {
                endpoint {
                    remote-endpoint = <&csiphy0_ep>; // 连接到SoC的MIPI CSI接口
                };
            };
        };
    };
};
不同厂商的摄像头 只要其加串器芯片与解串器兼容(如都支持GMSL2协议),并且驱动在设备树中正确配置了虚拟通道和I2C地址映射,就可以被系统正确识别和区分。驱动加载时,会解析设备树,为每个virtual-channel创建独立的数据通路。
4. 实际开发与调试要点
-
通道绑定:需要确保物理连接、设备树中的端口绑定与
virtual-channel号一一对应,不能冲突。 -
同步性:多路摄像头可能要求帧同步,这通常由解串器芯片输出一个同步信号给所有加串器来实现,驱动需配置相关寄存器。
-
电源管理:解串器可以控制每路摄像头的供电,实现分时唤醒,驱动需要集成这些电源序列。
-
诊断:SerDes芯片通常提供信号质量监测功能(如误码率),驱动可读取这些信息用于诊断线缆故障。
总结来说,多摄像头共享一个解串器的核心,是通过“虚拟通道”在数据链路层进行标记和复用,通过“I2C地址映射”在控制链路进行路由。高通的驱动框架通过设备树来描述这个拓扑,让软件能够透明地管理多个物理上独立的摄像头。
【问题】加串器是怎么实现把摄像头传感器产生的并行视频数据流转换为高速、抗干扰的串行差分信号的?
加串器将摄像头传感器的并行数据转换为高速串行差分信号,是一个精妙的信号处理过程。其核心在于并行到串行转换、时钟嵌入与恢复、以及针对长距离传输的抗干扰设计。
1. 核心转换流程与模块
整个转换过程可以被视为一个精密的“数据打包与强化发射”流水线,下图展示了其内部的关键步骤:
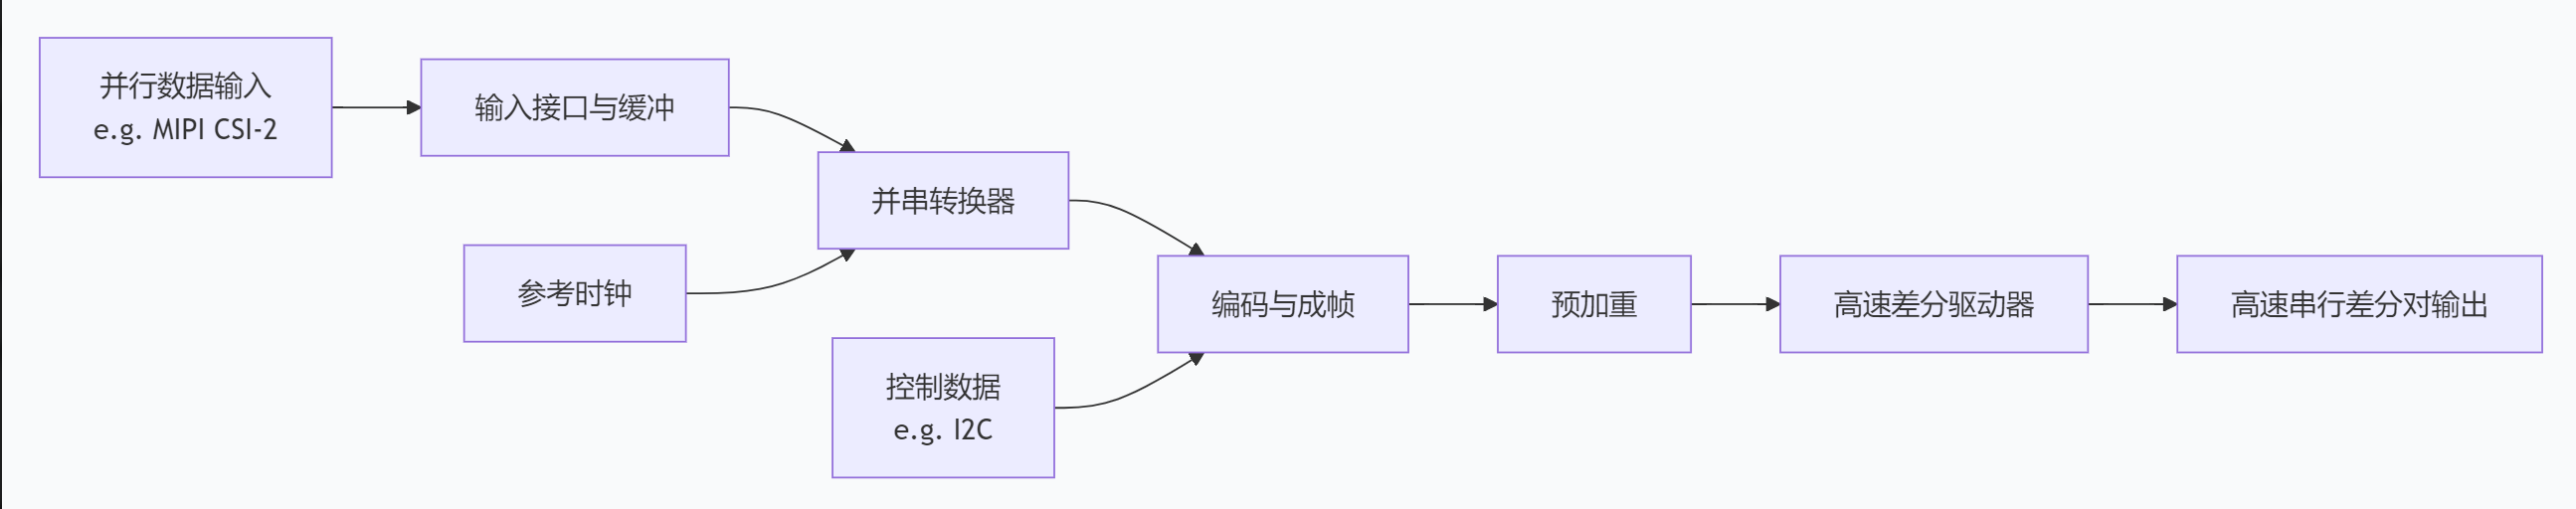
第1步:并行数据接收与缓冲
摄像头传感器(如通过MIPI CSI-2接口)输出多对差分数据线(如1-4对数据通道)和1对时钟通道。加串器的输入接口模块首先对这些信号进行缓冲、电平匹配和同步,将数据暂存在FIFO缓冲区中,以平滑时钟域的微小差异。
第2步:并串转换
这是核心环节。并串转换器以一个极高频率的本地时钟(由片内锁相环PLL产生),将缓存的并行数据“排队”取出。例如,假设输入是4对MIPI通道,每通道数据率为1.5 Gbps(总带宽6 Gbps),并串转换器会以4倍于单通道的速率(如6 Gbps)依次读取这4路数据,合并成一条极高速的串行数据流。
第3步:编码与成帧
原始二进制数据流可能包含长串的“0”或“1”,这会导致接收端时钟恢复困难。因此,加串器会使用编码方案(如8b/10b编码)来保证数据流中有足够的电平跳变,便于时钟恢复。同时,它将视频数据、控制信号(I2C/UART)、同步信号等打包成确定的帧结构,并在数据流中嵌入特定的控制字或对齐标识符,以便解串器能准确识别帧的开始与结束。
第4步:预加重与驱动
信号在长线缆中传输时,高频分量衰减远大于低频分量,会导致信号边沿模糊、眼图闭合。在发送前,预加重电路会预先增强信号跳变沿(高频分量) 的幅度。简单说,就是在电压从0跳变到1的瞬间,短暂地发送一个更高的电压,以补偿线缆的衰减,确保接收端能得到清晰的信号。
处理后的信号最后由高速差分驱动器输出,它会产生一对相位完全相反(互为镜像)的信号(TX+ 和 TX-),即差分信号。
2. 抗干扰与可靠传输的核心原理
这是加串器的“护身法宝”,主要依赖以下四点:
-
1. 差分信号传输:干扰噪声通常会同时、同等地耦合到差分线对的TX+和TX-上。在接收端,解串器只关心两者之间的电压差。由于噪声是共模的,电压差会被抵消,从而极强地抑制了共模噪声。
-
2. 预加重与接收端均衡:这是对抗信号衰减的“组合拳”。发送端的预加重预先补偿高频损失。在接收端,解串器则会采用均衡器,像一个智能的“反向滤波器”,再次提升被衰减的高频成分,共同确保信号完整性。
-
3. 稳定的时钟嵌入与恢复:加串器发送的串行数据流中已嵌入了时钟信息。解串器通过时钟数据恢复电路,从数据流的跳变沿中实时提取并重建出一个纯净、低抖动的时钟,用于精准采样数据,从根本上避免了独立时钟传输带来的偏移问题。
-
4. 错误检测与冗余:高级SerDes会包含循环冗余校验或前向纠错机制。CRC可以检测传输错误,FEC则能自动纠正一定数量的比特错误,这对安全至上的车载应用至关重要。
3. 控制通道的双向通信
除了高速前向视频通道,同一对线缆内还有一个独立的、低速的双向控制通道。它通常采用单线协议,允许主控SoC通过解串器,向远端的加串器和摄像头传感器发送配置命令(I2C/UART),并读取状态信息,实现了供电与控制“一线通”。
一个简化的例子:
假设传感器通过4条MIPI通道(每条1.5 Gbps)输出0x3A、0x8B、0xC4、0x59四个字节的数据。
-
加串器的并串转换器按顺序将它们拼接。
-
经过8b/10b编码,每个字节可能变为10位码(例如,
0x3A->1010101101),这确保了足够的跳变。 -
数据包被打包成帧,嵌入控制字。
-
预加重电路对跳变比特进行幅度增强。
-
差分驱动器将
1010...的比特流转换成电压形式,通过TX+和TX-线对发送出去。
解串器则执行完全逆向的过程,最终还原出原始的四个字节数据。
总结来说,加串器本质上是一个高度集成的高速信号调理与转发引擎。它的价值不仅在于转换数据格式,更在于通过一系列物理层技术,使得原始脆弱的并行信号能够抵御严苛的车载环境,实现可靠、远距离的传输。
openvela 操作系统专为 AIoT 领域量身定制,以轻量化、标准兼容、安全性和高度可扩展性为核心特点。openvela 以其卓越的技术优势,已成为众多物联网设备和 AI 硬件的技术首选,涵盖了智能手表、运动手环、智能音箱、耳机、智能家居设备以及机器人等多个领域。
更多推荐
 9
 0
- 0


 已为社区贡献1条内容

所有评论(0)